La Universidad de West Virginia anuncia una Maestría en Ciencias en Ingeniería de Software asequible y de primer nivel en Coursera

Por Betty Vandenbosch, directora de contenido de Coursera

Hoy, me complace anunciar una Maestría en Ciencias en Ingeniería de Software de la Universidad de West Virginia (WVU). Este título asequible cuesta $ 20,940 * y se ubica entre los 30 mejores programas de maestría en línea en tecnología de la información informática en los EE. UU.

WVU diseñó este programa para transformar a los profesionales de software y TI en expertos en la materia, enseñándoles cómo diseñar, desarrollar y administrar aplicaciones y sistemas de software. Los graduados tendrán las habilidades y credenciales necesarias para los más de 625 000 trabajos de ingeniería de software abierto que requieren una maestría en los EE. UU., según datos de Lightcast**.

Para dominar el ciclo de vida del desarrollo de software, los estudiantes definirán requisitos de software, arquetipos de programas usando diseño orientado a objetos, validarán software y desarrollarán programas usando el modelo de madurez de capacidad.

Los estudiantes pueden adaptar el plan de estudios a sus objetivos profesionales a través de cursos electivos avanzados, que van desde el desarrollo ágil de software y aplicaciones móviles hasta clases de administración de seguridad y computación en la nube. Los cursos son impartidos por profesores titulares en una de las principales instituciones de investigación del país, así como por expertos de la industria, incluidos ingenieros de software de la NASA y destacados ejecutivos de software.

“Nuestra asociación ampliada con Coursera es una aventura emocionante para los profesores y estudiantes de WVU”, dijo la rectora y vicepresidenta de Asuntos Académicos de WVU, Maryanne Reed. “Nos hemos centrado en los esfuerzos para crear programas innovadores que brinden habilidades en demanda y lleguen a los estudiantes donde están. Trabajar con Coursera para expandir nuestro programa de posgrado en Ingeniería de Software proporcionará una audiencia aún más amplia para este excelente programa. Estamos emocionados de dar la bienvenida a estudiantes de todo el mundo a la familia Mountaineer”.

Para ayudar a los estudiantes a equilibrar el trabajo de tiempo completo y la vida familiar, pueden completar los cursos en su propio horario. Los miembros de la facultad están disponibles para apoyar a los estudiantes en las horas de oficina en vivo, y para maximizar el compromiso, los compañeros colaborarán en proyectos grupales complejos del mundo real durante todo el programa.

La mayoría de los estudiantes comienzan el programa mientras se encuentran en funciones técnicas superiores, pero después de la graduación, la mayoría avanza a posiciones de liderazgo, según una Encuesta de ex alumnos de la Universidad de West Virginia de 2021 de 29 estudiantes. El sesenta y dos por ciento de los graduados en el campus encuestados aumentaron su salario o obtuvieron una promoción. Por ejemplo, un estudiante, Joe Oliverio, fue ascendido en una empresa Fortune 500 después de graduarse y dijo: «Este título me ha abierto puertas que nunca hubiera imaginado».

Nos sentimos honrados de expandir nuestra asociación con la Universidad de West Virginia para brindar a los estudiantes de todo el mundo un título asequible que pueda ayudarlos a desbloquear la siguiente etapa de sus carreras.

Las solicitudes ya están abiertas para la primera cohorte, a partir del verano de 2023. Para obtener más información y postularse, visite https://www.coursera.org/degrees/ms-software-engineering-wvu.

*Matrícula a partir del 29 de noviembre de 2022; La matrícula está sujeta a cambios. Si los estudiantes sin una licenciatura en informática, ingeniería informática, ingeniería de software o un campo estrechamente relacionado se postulan y son aceptados en el programa, deben completar SENG 505, lo que eleva el costo total de la carrera para estos estudiantes a $23,034. Más información aquí.

**Fuente: Resumen de Ocupaciones para Ciencias de la Computación e Ingeniería de Software Informático; Los trabajos abiertos indican puestos abiertos desde octubre de 2021 hasta septiembre de 2022; Consultado el 26 de octubre de 2022.
Un nuevo estudio sugiere que el cambio climático puede estar afectando el tamaño del cuerpo de los animales

Nueva evidencia muestra que algunos mamíferos aumentan de tamaño en entornos más cálidos, alterando las normas establecidas y sugiriendo que el cambio climático puede tener un impacto inesperado en el tamaño corporal de los animales.

El estudio*, publicado en Scientific Reports, encuentra que los cambios recientes en el tamaño corporal de las musarañas subvierten dos de las reglas ecogeográficas más estudiadas sobre la variación del tamaño corporal dentro de las especies.

De acuerdo con la regla de Bergmann, llamada así por el biólogo alemán del siglo XIX Carl Bergmann, quien describió el patrón en 1847, los individuos tienen cuerpos más grandes en climas más fríos (típicamente en latitudes más altas).

La segunda regla, llamada regla de Foster después de un estudio de 1964 realizado por el especialista en mamíferos J. Bristol Foster, predice que las poblaciones insulares de especies de cuerpo pequeño son, en promedio, más grandes que sus contrapartes continentales.

Los investigadores, dirigidos por Maya Juman [2022], un becario de Gates Cambridge y estudiante de doctorado en la Universidad de Cambridge, probó las reglas en el espacio y el tiempo simultáneamente en Northern Treeshrew, un pequeño mamífero nativo del sur y sureste de Asia. Utilizaron un conjunto de datos de especímenes de museo recopilados en un amplio rango espacial y temporal, junto con datos climáticos históricos asociados. Descubrieron que ambas reglas se han invertido rápidamente con el tiempo: la variación del tamaño corporal en los especímenes recolectados a fines del siglo XIX siguió los patrones predichos por las reglas de Bergmann y Foster, pero el patrón se invirtió en el siglo XX.

Según el estudio, el tamaño de Northern Treeshrews en el continente ha aumentado constantemente con el tiempo en entornos más cálidos, siendo la temperatura el predictor más importante del tamaño corporal, aunque no el único. La lluvia, por ejemplo, también juega un papel, ya que las áreas de mayor precipitación ven una relación más pronunciada entre la temperatura y el tamaño del cuerpo.

Los investigadores también descubrieron una interacción entre las dos reglas: la regla de Bergmann se mantiene en las poblaciones insulares pero no en las continentales, por lo que la regla de la isla se mantiene en latitudes más altas pero no más cerca del ecuador. El estudio demuestra la compleja variedad de factores dinámicos y potencialmente interdependientes que afectan el tamaño del cuerpo, que está vinculado a rasgos fisiológicos, ecológicos y de comportamiento críticos.

Los investigadores, de la Universidad de Cambridge, la Universidad de Yale, la Universidad de Alaska Fairbanks y la Universidad McGill, piden a los expertos que vuelvan a examinar las reglas ecogeográficas a la luz del calentamiento global para ver si el cambio climático puede estar reescribiendo las reglas. “Nuestro estudio es el primero en demostrar una inversión de reglas a lo largo del tiempo en cualquier especie”, dijo Juman. «Necesitamos revisar algunas de nuestras suposiciones sobre la variación de tamaño a medida que nuestro clima continúa cambiando rápidamente».

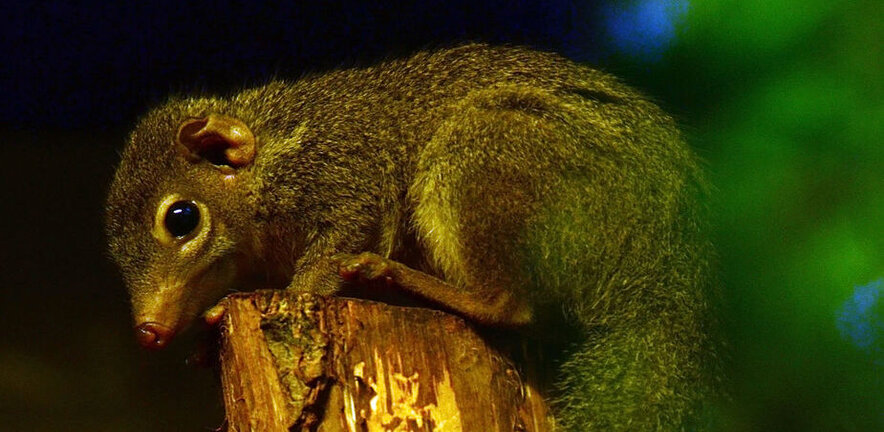
*Reversiones de reglas ecogeográficas recientes y rápidas en Northern Treeshrews por Maya M. Juman (Cambridge; Yale), Virginie Millien (McGill), Link E. Olson (Universidad de Alaska) y Eric J. Sargis (Yale). Crédito de la imagen: musaraña arborícola birmana (Tupaia belangeri) en Planckendael por Vassil. Cortesía de Wikimedia commons.

La no detección de la señal clave permite a los astrónomos determinar cómo eran y no eran las primeras galaxias.

Usando datos del radiotelescopio SARAS3 de la India, los investigadores dirigidos por la Universidad de Cambridge pudieron observar el universo muy temprano, solo 200 millones de años después del Big Bang, y establecer límites en la producción de masa y energía de las primeras estrellas y galaxias.

Contrariamente a la intuición, los investigadores pudieron establecer estos límites en las primeras galaxias al no encontrar la señal que habían estado buscando, conocida como la línea de hidrógeno de 21 centímetros.

Esta falta de detección permitió a los investigadores hacer otras determinaciones sobre el amanecer cósmico, poniendo restricciones en las primeras galaxias y permitiéndoles descartar escenarios que incluyen galaxias que eran calentadores ineficientes de gas cósmico y productores eficientes de emisiones de radio.

Si bien todavía no podemos observar directamente estas primeras galaxias, los resultados, publicados en la revista Naturaleza Astronomíarepresenta un paso importante para comprender cómo nuestro Universo pasó de estar mayormente vacío a uno lleno de estrellas.

Comprender el Universo primitivo, cuando se formaron las primeras estrellas y galaxias, es uno de los principales objetivos de los nuevos observatorios. Los resultados obtenidos con los datos de SARAS3 son un estudio de prueba de concepto que abre el camino para comprender este período en el desarrollo del Universo.

El proyecto SKA, que involucra dos telescopios de próxima generación que se completarán a fines de la década, probablemente podrá tomar imágenes del Universo primitivo, pero para los telescopios actuales, el desafío es detectar la señal cosmológica de las primeras estrellas. re-irradiado por espesas nubes de hidrógeno.

Esta señal se conoce como la línea de 21 centímetros, una señal de radio producida por átomos de hidrógeno en el Universo primitivo. A diferencia del JWST lanzado recientemente, que podrá obtener imágenes directamente de galaxias individuales en el Universo primitivo, los estudios de la línea de 21 centímetros, realizados con radiotelescopios como el REACH (Radio Experiment for the Analysis of Cosmic Hydrogen) dirigido por Cambridge, puede hablarnos de poblaciones enteras de galaxias incluso anteriores. Se esperan los primeros resultados de REACH a principios de 2023.

Para detectar la línea de 21 centímetros, los astrónomos buscan una señal de radio producida por átomos de hidrógeno en el Universo primitivo, afectados por la luz de las primeras estrellas y la radiación detrás de la niebla de hidrógeno. A principios de este año, los mismos investigadores desarrollaron un método que les permitirá ver a través de la niebla del universo primitivo y detectar la luz de las primeras estrellas. Algunas de estas técnicas ya se han puesto en práctica en el presente estudio.

En 2018, otro grupo de investigación que operaba el experimento EDGES publicó un resultado que insinuaba una posible detección de esta primera luz. La señal reportada fue inusualmente fuerte en comparación con lo que se espera en la imagen astrofísica más simple del Universo primitivo. Recientemente, los datos de SARAS3 cuestionaron esta detección: el resultado de EDGES todavía está esperando la confirmación de observaciones independientes.

En un nuevo análisis de los datos de SARAS3, el equipo dirigido por Cambridge probó una variedad de escenarios astrofísicos que podrían explicar potencialmente el resultado de EDGES, pero no encontraron una señal correspondiente. En cambio, el equipo pudo establecer algunos límites en las propiedades de las primeras estrellas y galaxias.

Los resultados del análisis SARAS3 son la primera vez que las observaciones de radio de la línea promediada de 21 centímetros han podido proporcionar una idea de las propiedades de las primeras galaxias en forma de límites de sus principales propiedades físicas.

Trabajando con colaboradores en India, Australia e Israel, el equipo de Cambridge usó datos del experimento SARAS3 para buscar señales del amanecer cósmico, cuando se formaron las primeras galaxias. Usando técnicas de modelado estadístico, los investigadores no pudieron encontrar una señal en los datos de SARAS3.

«Estábamos buscando una señal con cierta amplitud», dijo Harry Bevins, estudiante de doctorado del Laboratorio Cavendish de Cambridge y autor principal del artículo. «Pero al no encontrar esa señal, podemos poner un límite a su profundidad. Eso, en a su vez, comienza a informarnos sobre cuán brillantes eran las primeras galaxias”.

«Nuestro análisis mostró que la señal de hidrógeno puede informarnos sobre la población de las primeras estrellas y galaxias», dijo la coautora principal, la Dra. Anastasia Fialkov, del Instituto de Astronomía de Cambridge. “Nuestro análisis pone límites a algunas de las propiedades clave de las primeras fuentes de luz, incluidas las masas de las primeras galaxias y la eficiencia con la que estas galaxias pueden formar estrellas. También abordamos la cuestión de la eficiencia con la que estas fuentes emiten rayos X, radio y radiación ultravioleta”.

“Este es un primer paso para nosotros en lo que esperamos sea una década de descubrimientos sobre cómo el Universo pasó de la oscuridad y el vacío al complejo reino de las estrellas, galaxias y otros objetos celestes que podemos ver desde la Tierra hoy”, dijo el Dr. Eloy. por Lera Acedo del Laboratorio Cavendish de Cambridge, quien codirigió la investigación.

El estudio observacional, el primero de su tipo en muchos aspectos, excluye escenarios en los que las primeras galaxias eran más de mil veces más brillantes que las galaxias actuales en su emisión de banda de radio y eran pobres calentadores de gas hidrógeno.

“Nuestros datos también revelan algo que se ha insinuado antes, y es que las primeras estrellas y galaxias podrían haber tenido una contribución medible a la radiación de fondo que apareció como resultado del Big Bang y que ha estado viajando hacia nosotros desde entonces. ” dijo de Lera Acedo, “También estamos estableciendo un límite a esa contribución”.

“Es increíble poder mirar tan atrás en el tiempo, hasta 200 millones de años después del Big Bang, y poder aprender sobre el Universo primitivo”, dijo Bevins.

La investigación fue apoyada en parte por el Consejo de Instalaciones de Ciencia y Tecnología (STFC), parte de Investigación e Innovación del Reino Unido (UKRI) y la Royal Society. Los autores de Cambridge son todos miembros del Instituto Kavli de Cosmología de Cambridge.

Referencia:
HTJ Bevins et al. ‘Restricciones astrofísicas de la no detección de SARAS 3 de la señal promedio de 21 cm del cielo del amanecer cósmico.’ Astronomía de la naturaleza (2022). DOI: 10.1038/s41550-022-01825-6

Ingeniería de datos versus ingeniería de software

Cuando la mayoría de la gente piensa en trabajadores de tecnología, probablemente piensen en ingenieros de software. Piensan en las personas que se sientan frente a una computadora todo el día, codificando sitios web y aplicaciones. En realidad, hay muchos tipos diferentes de trabajadores tecnológicos.

Algunos ingenieros pasan todo el día codificando sitios web (estos se conocen como ingenieros de software), pero otros dedican su tiempo a construir canalizaciones de datos para ayudar a los analistas de datos a hacer su trabajo (estos se llaman ingenieros de datos).

Hay un poco de superposición entre los ingenieros de software y los ingenieros de datos. Siga leyendo para conocer las principales diferencias y similitudes entre los ingenieros de software y los ingenieros de datos.

Herramientas y habilidades para el trabajo.

Hay mucha superposición entre los ingenieros de software y los ingenieros de datos cuando se trata de habilidades y herramientas para el trabajo. Ambos roles requieren una habilidad para codificar, una buena comprensión de los algoritmos y una sólida comprensión de las bases de datos. Las diferencias entre los dos se reducen a los detalles.

Los ingenieros de software usan lenguajes de codificación como JavaScript, Python, C/C++, Ruby y Go. Utilizan marcos como React, Ruby on Rails, Django, Vue, etc. Las herramientas que usan en el trabajo incluyen Git, Amazon Web Services (AWS) y Código VS.

Los ingenieros de datos pasan algún tiempo codificando, pero ese no es el enfoque principal de su trabajo. Cuando lo hacen, normalmente usan lenguajes como Python, R y Java. Sus herramientas de software preferidas son Looker, Kafka, Tableau, Snowflake, SQL, Redshift y BigQuery.

Usuarios finales del producto.

Una de las mayores diferencias entre los ingenieros de software y los ingenieros de datos es quién utilizará el producto en el que están trabajando.

Los ingenieros de software generalmente desarrollan para los clientes del sitio web, las aplicaciones o el software. Los usuarios son personas externas a la organización, que pueden o no estar pagando por usar el producto.

Los ingenieros de datos generalmente desarrollan herramientas internas que utilizan los miembros dentro de sus propias organizaciones. Los usuarios tienden a ser analistas de datos y científicos de datos, aunque también pueden ser gerentes de productos y otros ingenieros.

Salario.

Si bien tanto los ingenieros de software como los ingenieros de datos ganan mucho dinero, a los ingenieros de datos se les paga un poco mejor que a los ingenieros de software. Esto se debe al hecho de que no hay tantos ingenieros de datos como ingenieros de software, y la habilidad especializada tiene una gran demanda.

El salario base promedio de un ingeniero de software en los Estados Unidos es de $ 94,000, con un salario promedio de nivel de entrada que comienza alrededor de $ 87,000 y desarrolladores experimentados que ganan un promedio de $ 118,000.

El salario base promedio de un ingeniero de datos en los Estados Unidos es de $115 000, y los desarrolladores experimentados ganan un promedio de $148 000.

Comience su carrera en ingeniería de datos o software Este Dia.

Ya sea que esté interesado en la ingeniería de datos o la ingeniería de software, nunca ha habido un mejor momento para comenzar a aprender a codificar. Desde excelentes salarios hasta amplias oportunidades de crecimiento profesional, convertirse en ingeniero de software o ingeniero de datos es un gran paso.

Para comenzar su camino para aprender a ser ingeniero de datos o ingeniero de software, consulte los programas de nanogrados de Udacity hoy.

COMIENZA A APRENDER

¿Hay método para la locura de Musk en Twitter? –Gaceta de Harvard

Desde que Elon Musk, el hombre más rico del mundo, compró Twitter por 44.000 millones de dólares el mes pasado, la empresa ha sufrido una serie de cambios abruptos. Algunos cambios, como el despido de Musk del 50 por ciento de los 7.000 empleados de la empresa, fueron deliberados. Pero otros, como la huelga de más de 1000 empleados clave adicionales de infraestructura, así como los anunciantes, no lo fueron.

El deseo declarado de Musk de hacer de Twitter un refugio para cualquier discurso «dentro de los límites de la ley» ha llevado a un fuerte aumento en las publicaciones que defienden el nacionalismo blanco, el antisemitismo, la homofobia y las amenazas de violencia política de la derecha, lo que ha llevado a muchos usuarios a reconsiderar si seguirán usando la plataforma.

Los críticos dicen que todos estos movimientos radicales son como prender fuego al dinero de los inversores de Twitter. Pero, ¿hay algún método para la locura de Musk?

Andy Wu es profesor asistente de administración de empresas en la Escuela de Negocios de Harvard y estudia a los empresarios tecnológicos y las estrategias que utilizan para obtener una ventaja competitiva. Wu habló con The Gazette sobre su opinión sobre los movimientos recientes de Musk. La entrevista ha sido editada para mayor claridad y duración.

GACETA: Muchos de los movimientos de Elon Musk en Twitter han sido ampliamente criticados por ser erráticos e incluso temerarios. Algunos en tecnología sugieren que hay más de una estrategia de «moverse rápido, romper cosas» de lo que parece. ¿Cómo te parece?

Wu: No debería sorprendernos el estilo de gestión que Musk está adoptando en Twitter. Lo que está haciendo aquí es consistente con la forma en que opera SpaceX y Tesla y sus otros negocios. Si bien no se trata de construir autos eléctricos o ir a Marte, la situación en la que Musk está entrando en Twitter es desafiante y podría requerir un líder que esté dispuesto a correr algunos riesgos aquí en lugar de seguir siendo conservador como lo ha sido Twitter durante un tiempo. . Antes de la adquisición, Twitter como empresa era mucho más débil de lo que la mayoría de la gente cree. Han luchado con la rentabilidad durante muchos años y han sido bastante lentos a la hora de innovar en nuevas funciones y oportunidades de crecimiento. Al hacer este trato y tener la atención de los medios en Twitter, todo lo que realmente estamos haciendo es exponer al público gran parte de esa debilidad que simplemente no habíamos notado o en la que no habíamos pensado antes.

Definitivamente hay muchas asperezas en lo que Musk ha estado haciendo hasta ahora en Twitter. Pero diría que muchos de estos errores, incluso a veces ridículos, que hemos visto en las últimas semanas son una consecuencia inevitable de tener que tomar algunos tipos de decisiones aquí muy, muy rápido. Por ejemplo, un gran desafío para Twitter es que su estructura de costos en curso está un poco fuera de control y, según cualquier métrica, está por encima de compañías de redes sociales comparables. Y entonces, definitivamente hay un incentivo aquí para que intenten alinear eso más temprano que tarde.

Si compara Meta/Facebook con Twitter, Facebook ha tenido el doble de ingresos por empleado que Twitter, y Facebook tiene significativamente más empleados trabajando en iniciativas innovadoras de largo alcance que Twitter. En gran medida, Twitter fue ineficiente para mantener sus operaciones en curso, así como para innovar en nuevas funciones. Entonces, el hecho de que Musk viniera y luego despidiera a la mitad de la compañía es consistente con tratar de alinear ese punto de referencia en particular. Definitivamente debemos sentir simpatía por todas las personas en Twitter que han pasado por esto. Pero al mismo tiempo, no debería sorprendernos que Musk haya elegido comenzar de esta manera.

GACETA: Incluso antes de la compra de Musk, Twitter era un negocio influyente pero no rentable que perdió dinero en ocho de los últimos 10 años. Ahora, los ingresos por publicidad digital están cayendo bastante rápido en Internet, y los anunciantes están haciendo una pausa o abandonando Twitter. ¿Cuál es la perspectiva financiera de la empresa?

Wu: Definitivamente es una situación precaria para la empresa. Debemos tener en cuenta que Musk y sus coinversores tienen más capital disponible en caso de que quieran rescatar nuevamente a la empresa. Entonces, en ese sentido, teóricamente tienen cierta flexibilidad sobre qué hacer con los próximos pagos de intereses sobre la deuda que se ha asumido. Dicho esto, la caída de los ingresos por publicidad probablemente ha sido más dramática de lo que nadie esperaba. Los anunciantes tienen razón en al menos hacer una pausa aquí y pensar si quieren seguir involucrados con Twitter. A largo plazo, Musk ciertamente quiere generar flujos de ingresos más allá de la publicidad, pero aún no sabemos si las membresías premium o los pagos financieros o cualquier otra idea podrán compensar la pérdida de ingresos por publicidad. Pero definitivamente lo intentarán.

Una gran motivación para este acuerdo fue que Musk y sus co-inversionistas como Peter Thiel y otros realmente querían construir y proteger una visión de Twitter como un foro público o una plaza pública para la libertad de expresión. Su idea preconcebida de la libertad de expresión es política e ideológicamente divisiva. Y por una buena razón, hay muchos anunciantes que no quieren estar afiliados a esa definición de libertad de expresión. Pero si esa es la visión por la que quieren ir, inevitablemente necesitan encontrar una forma de monetizar el negocio que no sean los ingresos por publicidad, porque la pérdida de ingresos por publicidad es un costo que enfrentarán a perpetuidad. La reacción de los anunciantes hoy es más bien un preludio de lo que podría suceder en el futuro. Hasta ahora, no hemos visto tantos cambios estructurales en el negocio, y los cambios y experimentos se están implementando gradualmente día a día.

Udacity aumenta el ROI con la mejora de las habilidades digitales

Una organización líder en servicios financieros estaba al borde de la turbulencia de talentos. ¿Nuestro plan? Transformar a su gente en su mayor oportunidad.

El éxito de la inversión era innegable.

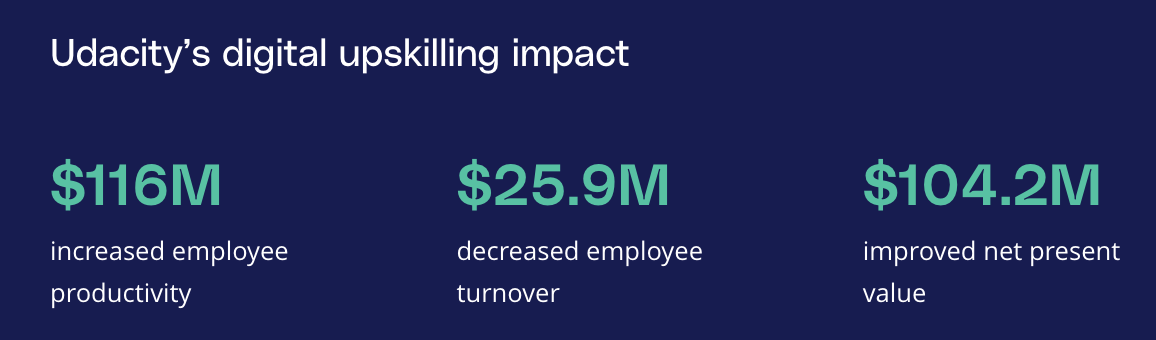
Los resultados positivos de la mejora de habilidades de Udacity pronto se hicieron evidentes. La empresa experimentó un aumento del valor comercial de $148,7 millones y un ROI del 234 % con un período de recuperación de menos de 3 meses. La productividad de los empleados se disparó generando $116 millones. Además, ahorraron 25,9 millones de dólares gracias a la reducción de la rotación de empleados y 6,7 millones de dólares gracias a la reducción de los gastos normativos y de auditoría, todo gracias a Udacity.

No todas las mejoras digitales son iguales.

Antes de adoptar Udacity, esta organización utilizó una combinación de recursos de aprendizaje en un intento por cerrar las brechas de talento. Implementaron plataformas digitales, documentación impresa e incluso clases presenciales. Este enfoque era complicado, lento e ineficaz.

Planes de aprendizaje personalizados para adaptarse mejor a las necesidades únicas.

Udacity comenzó evaluando las brechas de talento para comparar con precisión el estado actual del negocio y priorizar adecuadamente los objetivos. Definimos una estrategia de transformación del talento que podría implementarse en toda la organización.

Este enfoque altamente seleccionado funcionó y ayudó a esta empresa finserv tradicionalmente no técnica a satisfacer las demandas modernas de transformación digital.

“Udacity ha sido un trampolín clave para cerrar las brechas de nuestros esfuerzos de transformación y modernización liderados por la industria”.

– Arquitecto empresarial de la empresa.

Resuelva los desafíos de su fuerza laboral.

Descargue el estudio completo Total Economic Impact™ de Forrester Consulting para ver cómo Udacity puede impulsar el ROI de la capacitación. Además, obtenga más información sobre cómo Udacity puede ayudar a su organización a generar resultados comerciales de nivel superior a través de la transformación digital con Udacity for Enterprise.

DESCARGAR INFORME


Destellos de movimiento, esperanza en la COP27 – Harvard Gazette

Negociadores climáticos de todo el mundo concluyeron recientemente conversaciones en Egipto que fueron a la vez frustrantes y esperanzadoras: frustrantes porque hicieron poco para acelerar el lento ritmo de acción para reducir las emisiones de carbono, y esperanzadoras debido a un diálogo renovado entre los mayores emisores del mundo y movimiento para abordar los daños relacionados con el clima en las naciones más vulnerables del mundo. The Gazette habló con Robert Stavins, profesor AJ Meyer de Energía y Desarrollo Económico de la Escuela Kennedy de Harvard, director del Proyecto de Harvard sobre Acuerdos Climáticos y asistente habitual a las cumbres anuales, para comprender mejor los éxitos y fracasos en la 27ª Conferencia de la Partes de la Convención Marco de las Naciones Unidas sobre el Cambio Climático.

GACETA: ¿Qué destaca de la COP27, la conferencia sobre cambio climático de este año?

STAVINS: Se destacan dos cosas, una de las cuales no se ha hablado y creo que es el desarrollo más importante para la política climática a largo plazo. El segundo es el tema de pérdidas y daños. La primera es que desde que Donald Trump fue elegido presidente en noviembre de 2016, una pregunta importante ha sido: ¿cuándo regresarían Estados Unidos y China a lo que había sido un co-liderazgo altamente efectivo durante los años de Obama? El acuerdo de París no se habría logrado de no haber sido por la cooperación entre China y Estados Unidos. Esa cooperación se interrumpió con Trump y luego no volvió con Biden debido a desacuerdos sobre comercio internacional, derechos humanos, Mar de China Meridional, Hong Kong, Taiwán y otros temas no climáticos.

En la COP27 obtuvimos el principio de la respuesta, aunque de manera sorprendente. El acontecimiento más importante durante la COP27 tuvo lugar a 6.000 millas de distancia, en Bali, Indonesia, el 14 de noviembre. El presidente de los Estados Unidos, Joe Biden, y el presidente de China, Xi Jinping, se reunieron al margen de la cumbre del G-20. Se dieron la mano y entablaron una conversación de tres horas en la que señalaron su regreso a la postura cooperativa que había sido tan crucial para el progreso internacional sobre el cambio climático. Eso rápidamente llegó a los jefes de los respectivos equipos de negociación en la COP27, John Kerry por los Estados Unidos y Xie Zhenhua por China. Son amigos pero no habían tenido discusiones por los problemas entre los dos gobiernos. Una vez que tuvo lugar la reunión en Bali, llegaron declaraciones tanto de John Kerry como de Xie Zhenhua indicando que los dos países planean reanudar la cooperación, y que se habían reunido y conversado en varias ocasiones.

GACETA: ¿Qué hace que estos dos países sean tan potencialmente poderosos cuando trabajan juntos? ¿Es solo el tamaño y la influencia global?

STAVINS: Es en parte el tamaño y la influencia global, pero más específicamente, es que son los dos mayores emisores en términos de gases de efecto invernadero. Además, Estados Unidos ha sido tradicionalmente el líder del mundo occidental en muchos temas, y China, a través de lo que se denomina el «G-77 más China», que son 134 países en desarrollo, desempeña un papel de liderazgo en el mundo en desarrollo. Estos son los dos grupos más importantes para las negociaciones climáticas y son los respectivos líderes.

GACETA: Otro tema de la COP27 es la falta de aumento de las promesas de reducción de emisiones por parte de diferentes naciones, lo que se esperaba después de Glasgow. ¿Es eso algo que podría suceder debido a esta cooperación entre Estados Unidos y China?

STAVINS: Esencialmente, en cada elemento en el que haya un progreso deseado, que sea factible y razonable, China y EE. UU. pueden desempeñar un papel crucial. Fueron los primeros en salir de la puerta con sus NDC. [Nationally Determined Contributions to emission reductions under the Paris climate agreement] eso se convirtió en un viento en la espalda de las otras delegaciones. Una cosa es que la Unión Europea salga al frente porque siempre lo hace. Eso no atrae a muchos otros países. Una cosa es que Costa Rica esté al frente entre los países en desarrollo, pero eso no atrae a muchos países. Estados Unidos y China traen una multitud de otros países cuando cooperan y juegan un papel de liderazgo.

GACETA: ¿Qué puede decirme sobre el nuevo fondo para pérdidas y daños?

STAVINS: La decisión más dramática y polémica dentro de los pasillos de la COP27, por parte de los negociadores de 195 países, fue el establecimiento de un fondo para las llamadas pérdidas y daños. Este es un problema que ha sido pateado en el camino durante mucho tiempo. Se lanzó por primera vez en 1991 cuando Vanuatu, una pequeña nación insular en el Pacífico, sugirió la creación de un fondo de este tipo para pagar las consecuencias del aumento del nivel del mar, y durante 30 años se ha retrasado la acción. En la COP27, los países en desarrollo presionaron para establecer un fondo explícito para esto. China se pronunció a favor de un fondo explícito para pérdidas y daños, aunque también dijeron que no iban a invertir dinero en él. Luego, la Unión Europea dijo que lo apoyaba, eso era muy importante, y luego algunos otros países desarrollados salieron a apoyarlo. Luego, en la segunda semana de la COP, en un anuncio bastante dramático, John Kerry dijo que Estados Unidos estaba cambiando de posición. Antes de que comenzara la COP, dijo: “No apoyamos la creación de tal fondo”.

GACETA: ¿Qué tan grande será el fondo?

STAVINS: Por el lado de la demanda, tal fondo eventualmente podría ascender a billones de dólares por año. La estimación del Banco Mundial de los daños causados ​​por las inundaciones de este año solo en Pakistán es de 40.000 millones de dólares. Entonces, si imagina el cambio climático aumentando en intensidad con el tiempo en países de todo el mundo, puede ver por qué fácilmente podría ascender a cientos de miles de millones, de hecho, billones, por año. Sin embargo, por el lado de la oferta, hay muy pocas promesas cuantitativas hasta el momento: decenas de millones de dólares, triviales en comparación con lo que será la demanda. Entonces, para mí, la pregunta es: ¿Es el nuevo fondo para pérdidas y daños una cáscara vacía?

La posición anunciada por China en la COP27 fue que apoya la creación del fondo para pérdidas y daños, pero como “país en desarrollo” no será responsable de ninguna contribución al fondo. Encontrará muchas citas en las que se describen a sí mismos como un país en desarrollo y se refieren a las definiciones de países del «anexo uno» y «no anexo uno» en 1992, bajo las Naciones Unidas. Convención Marco sobre el Cambio Climático. Entonces, el PIB per cápita de China era menos de $400 por año. No hablan del hecho de que el PIB per cápita en China ha crecido un 3330 por ciento desde entonces.

De hecho, hay cierta convergencia en el tema del fondo de pérdidas y daños entre China y Estados Unidos, aunque no con respecto a la autoproclamada exención de China del estado de contribuyente financiero: Estados Unidos ha dicho abiertamente que China debería ser un contribuyente. Ya no son un país pobre en desarrollo, son un importante contribuyente a la «reserva» atmosférica de gases de efecto invernadero (los daños son una función de la reserva, no de las emisiones) y el mayor contribuyente a las emisiones anuales.

La razón por la que digo que hay convergencia es que Estados Unidos tiene una historia que lo coloca en un lugar similar: “Apoyamos el fondo para pérdidas y daños, pero debido a la nueva mayoría republicana en la Cámara de Representantes, es imposible nosotros para hacer cualquier compromiso de nueva financiación.” Eso no se establece explícitamente, pero esa es esencialmente la posición de los EE. UU. Creo que es por eso que Kerry podría hacer este cambio, porque no hay forma de que haya dinero.

GACETA: Con la COP terminada, ¿cómo cree que lo estamos haciendo? Las predicciones del Panel Intergubernamental sobre el Cambio Climático (IPCC) de la ONU son cada vez más nefastas. La gente habla de plazos cada vez más cortos. Mantener el calor a 1,5 grados centígrados parece cada vez menos probable.

STAVINS: Ha habido muchas declaraciones de decepción con respecto a esta COP, porque la declaración de clausura no abarcó por completo el objetivo de 1,5 grados C. Pero esa habría sido una resolución no vinculante frente al objetivo de 2 grados centígrados, que es un compromiso en el acuerdo de París. Puede que sea un tipo que ve el vaso medio lleno, pero recuerdo cuando las estimaciones habituales del IPCC sobre el cambio de temperatura para este siglo eran de hasta 7 grados centígrados. Con los NDC de París, eran 3 grados centígrados. Y ahora, con los nuevos compromisos asumidos por los países, incluido EE. UU., más las enmiendas de Kigali al Protocolo de Montreal, estamos hablando de 2,5 grados C. Reconozco que 2,5 grados está muy lejos de 1,5, pero también es mucho lejos de donde estábamos.

GACETA: ¿Se siente relativamente seguro de que la trayectoria seguirá mejorando a medida que avanzamos?

STAVINS: No diría «relativamente seguro», pero ciertamente tengo esperanzas. Está condicionado a los desarrollos políticos en China, en los Estados Unidos, en la Unión Europea, el otro contribuyente importante, pero sabemos a dónde van. China es el gran signo de interrogación. Tenemos que esperar y ver. Estados Unidos también es un signo de interrogación porque alternamos entre administraciones y congresos demócratas y republicanos, lo que vuelve locos a los demás países del mundo. Rusia también es un emisor muy grande, pero casi se ha retirado de las discusiones, porque tiene otras cosas de qué preocuparse.

Estructuras de datos y algoritmos en Python

No importa qué tipo de programa de Python esté escribiendo, es muy probable que descubra que su programa necesita manejar algunos datos. A veces, los datos deben almacenarse, analizarse, manipularse, ordenarse, transferirse o incluso usarse como entrada en modelos de aprendizaje automático. Dado que los datos son tan importantes en el mundo de Python, es valioso estudiar cuidadosamente cómo manejarlos de manera correcta y eficiente.

En este artículo, discutiremos estructuras de datos y los formatos estándar para organizar y almacenar datos en Python. también discutiremos algoritmos, los conjuntos ordenados de instrucciones que se utilizan para procesar datos. Hablaremos sobre estos dos conceptos e ilustraremos los conceptos con el código de trabajo de Python. ¡Vamos a empezar!

Primeros pasos: una lista y una tupla.

Comencemos definiendo algunos datos simples en Python:

Aquí, creamos un objeto en Python llamado my_list. Este objeto es una colección de números. Pero más precisamente, este objeto se llama lista. Una lista es simplemente una colección de elementos, almacenados juntos en una sola variable. Creamos listas en Python usando los corchetes ([ and ]) y separando los elementos individuales con comas.

Esta no es la única forma de crear una colección de elementos en Python. Intentemos usar paréntesis en lugar de corchetes:

Este nuevo objeto, llamado my_tuple, contiene los mismos números que my_list. Pero como usamos paréntesis en lugar de corchetes, llamamos a este objeto un tupla en lugar de una lista.

Comparación de listas y tuplas.

Las listas y las tuplas son similares en muchos aspectos. Por ejemplo, podemos acceder a elementos individuales en listas y tuplas de la misma manera:

print(my_list[3])
print(my_tuple[3])

Aquí, imprimimos el elemento con el índice 3 tanto en my_list como en my_tuple, y vemos el mismo resultado para ambos comandos (8). Puedes ver que de esta manera, las listas y las tuplas funcionan igual.

Pero las listas y las tuplas no son lo mismo en todos los sentidos. Veamos qué sucede si intentamos cambiar un valor en nuestra lista y nuestra tupla:

my_list[3] = 7
my_tuple[3] = 7

La primera línea aquí redefine el 8 en my_list para que sea igual a 7. La segunda línea parece que debería hacer lo mismo para my_tuple, pero si intenta ejecutarlo, obtendrá un error. Esto se debe a que las listas y las tuplas tienen reglas diferentes sobre la asignación de valores: se permite asignar nuevos valores a los elementos de las listas, pero no se permite asignar nuevos valores a los elementos de las tuplas. La palabra técnica para esta propiedad es mutabilidad; dado que los elementos de la lista se pueden cambiar, decimos que las listas son mudabley dado que los valores de las tuplas no se pueden cambiar, decimos que son inmutable. Las tuplas y las listas pueden parecer similares, pero la diferencia en su mutabilidad muestra que no son idénticas.

Las listas y las tuplas son dos formatos ligeramente diferentes para almacenar datos en Python. En otras palabras, son dos diferentes. estructuras de datos. Familiarizarse con los tipos de estructuras de datos que se pueden crear en Python lo ayudará a trabajar con datos de manera más efectiva.

Ejemplo 1: ordenar una lista de números.

Ahora que hemos presentado cómo almacenar datos en dos tipos de estructuras de datos, hagamos más con los datos. Comencemos definiendo nuestra lista nuevamente:

Puede ver que esta lista parece estar en un orden aleatorio: no está ordenada de menor a mayor ni de mayor a menor. A menudo, tendremos la necesidad de clasificar los datos, por lo que será útil comprender los conjuntos sistemáticos de instrucciones, o algoritmosque se utilizan para tareas como ordenar.

Piensa en cómo podrías escribir código para ordenar una lista de números como este del más pequeño al más grande. Una cosa con la que podría comenzar es un simple intercambio: tome dos números que están fuera de orden y cámbielos de lugar. Comencemos con 3 y 1, los elementos con índice 1 y 2, respectivamente, en nuestra lista:

the_index = 1
if my_list[the_index] > my_list[the_index+1]:
    my_list[the_index],my_list[the_index+1] = my_list[the_index+1],my_list[the_index]

Este código es sencillo: comprueba si un elemento de la lista en particular es mayor que el siguiente elemento de la lista. Si algún elemento es mayor que su sucesor en la lista, entonces esos dos elementos están fuera de servicio y, por lo tanto, el código los intercambia. Si ejecuta este código, luego ejecute print(my_list), obtendrá el siguiente resultado:

La lista aún no está completamente ordenada, pero hicimos una mejora: intercambiamos el 3 con el 1 para que al menos esos dos elementos estén ordenados de menor a mayor.

Si hacemos intercambios repetidos como este, eventualmente se ordenará toda la lista. Ese es el objetivo del siguiente código:

number_of_passes = 0

while number_of_passes < (len(my_list)):
    the_index = 0
    while the_index < (len(my_list)-1):
        if my_list[the_index] > my_list[the_index+1]:
            my_list[the_index],my_list[the_index+1] = my_list[the_index+1],my_list[the_index]
        the_index +=1
    number_of_passes+=1

Puede ver el mismo código que usamos para intercambiar dos elementos en el medio de este fragmento de código. Pero en lugar de intercambiar solo dos elementos, este código contiene bucles anidados que realizan intercambios repetidos de todos los elementos de nuestra lista, suficientes veces para que finalmente se ordene toda la lista. Después de ejecutar este código, puede ejecutar print(my_list) para ver que la lista está ordenada correctamente de menor a mayor.

Este proceso para ordenar una lista tiene un nombre especial: se llama hechizo de burbuja, y es un algoritmo simple para ordenar datos. A medida que avanza en su educación de Python, puede aprender más algoritmos como la ordenación de burbujas y cómo usarlos bien. También puede obtener información sobre más estructuras de datos, como listas y tuplas, y cómo cada estructura de datos puede ayudarlo a escribir código de Python efectivo.

Ejemplo 2: ordenar una lista de tuplas.

Ahora que está familiarizado con las listas y las tuplas (dos estructuras de datos) y la ordenación de burbujas (un algoritmo), probemos un ejemplo que los combine a todos. El siguiente código define una lista cuyos elementos individuales son todos tuplas. Luego, usa la ordenación de burbujas para ordenar la lista de menor a mayor en función del primer elemento de cada tupla:

list_of_tuples = [(3,5),(1,9),(2,8),(0,5),(9,6)]

number_of_passes = 0
while number_of_passes < (len(list_of_tuples)):
    the_index = 0
    while the_index < (len(list_of_tuples)-1):
        if list_of_tuples[the_index][0] > list_of_tuples[the_index+1][0]:
            list_of_tuples[the_index],list_of_tuples[the_index+1] = list_of_tuples[the_index+1],list_of_tuples[the_index]
        the_index +=1
    number_of_passes+=1

print(list_of_tuples)

Después de ejecutar este código, verá el siguiente resultado:

[(0, 5), (1, 9), (2, 8), (3, 5), (9, 6)]

Puede ver que nuestra lista de tuplas está ordenada de menor a mayor según el primer elemento de cada tupla. (La primera tupla tiene el primer elemento más pequeño, 0, la segunda tupla tiene el segundo primer elemento más pequeño, 1, y así sucesivamente, y luego la última tupla tiene el primer elemento más grande, 9). ¡Felicitaciones! Puede trabajar con múltiples estructuras de datos en Python y puede implementar un algoritmo de clasificación.

Más información sobre estructuras de datos y algoritmos.

Las estructuras de datos pueden parecer simples y los algoritmos que usamos para trabajar con ellas pueden parecer mundanos. Pero dominar algunas de estas ideas simples puede ayudarlo a escribir código Python mejor, de manera más eficiente y más rápida. Cuando llegue a las ideas más avanzadas en el mundo de Python, se alegrará de haber dominado algunos de estos conceptos básicos.

Si encuentra estos temas interesantes o útiles, explore el nanogrado de estructuras de datos y algoritmos de Udacity. Puede utilizar las habilidades y los conocimientos fundamentales adquiridos en el curso para crear proyectos de Python en cualquier nivel de sofisticación.

COMIENZA A APRENDER

Estudio de enanas blancas ‘contaminadas’ encuentra que las estrellas y los planetas crecen juntos

Un estudio de algunas de las estrellas más antiguas del Universo sugiere que los componentes básicos de planetas como Júpiter y Saturno comienzan a formarse mientras una estrella joven está creciendo. Se pensaba que los planetas solo se forman una vez que una estrella ha alcanzado su tamaño final, pero nuevos resultados, publicados en la revista Naturaleza Astronomíasugiere que las estrellas y los planetas ‘crecen’ juntos.

La investigación, dirigida por la Universidad de Cambridge, cambia nuestra comprensión de cómo se formaron los sistemas planetarios, incluido nuestro propio Sistema Solar, resolviendo potencialmente un gran rompecabezas en astronomía.

“Tenemos una idea bastante buena de cómo se forman los planetas, pero una pregunta pendiente que hemos tenido es cuándo se forman: ¿la formación de planetas comienza temprano, cuando la estrella madre aún está creciendo, o millones de años después?”. dijo la Dra. Amy Bonsor del Instituto de Astronomía de Cambridge, la primera autora del estudio.

Para intentar responder a esta pregunta, Bonsor y sus colegas estudiaron las atmósferas de las estrellas enanas blancas, los restos antiguos y débiles de estrellas como nuestro Sol, para investigar los componentes básicos de la formación de planetas. En el estudio también participaron investigadores de la Universidad de Oxford, la Ludwig-Maximilians-Universität de Múnich, la Universidad de Groningen y el Instituto Max Planck para la Investigación del Sistema Solar de Gotinga.

“Algunas enanas blancas son laboratorios asombrosos, porque sus atmósferas delgadas son casi como cementerios celestiales”, dijo Bonsor.

Normalmente, el interior de los planetas está fuera del alcance de los telescopios. Pero una clase especial de enanas blancas, conocidas como sistemas ‘contaminados’, tienen elementos pesados ​​como magnesio, hierro y calcio en sus atmósferas normalmente limpias.

Estos elementos deben haber venido de pequeños cuerpos como asteroides sobrantes de la formación de planetas, que chocaron contra las enanas blancas y se quemaron en sus atmósferas. Como resultado, las observaciones espectroscópicas de enanas blancas contaminadas pueden sondear los interiores de esos asteroides destrozados, brindando a los astrónomos una visión directa de las condiciones en las que se formaron.

Se cree que la formación de planetas comienza en un disco protoplanetario, compuesto principalmente de hidrógeno, helio y diminutas partículas de hielo y polvo, que orbita alrededor de una estrella joven. De acuerdo con la teoría líder actual sobre cómo se forman los planetas, las partículas de polvo se adhieren entre sí y eventualmente forman cuerpos sólidos cada vez más grandes. Algunos de estos cuerpos más grandes continuarán acrecentándose, convirtiéndose en planetas, y algunos permanecerán como asteroides, como los que chocaron contra las enanas blancas en el estudio actual.

Los investigadores analizaron observaciones espectroscópicas de las atmósferas de 200 enanas blancas contaminadas de galaxias cercanas. Según su análisis, la mezcla de elementos que se observa en las atmósferas de estas enanas blancas solo puede explicarse si muchos de los asteroides originales se hubieran derretido alguna vez, lo que provocó que el hierro pesado se hundiera hasta el núcleo mientras que los elementos más ligeros flotaban en la superficie. Este proceso, conocido como diferenciación, es lo que hizo que la Tierra tuviera un núcleo rico en hierro.

“La causa del derretimiento solo se puede atribuir a elementos radiactivos de vida muy corta, que existieron en las primeras etapas del sistema planetario pero se descomponen en solo un millón de años”, dijo Bonsor. “En otras palabras, si estos asteroides fueron derretidos por algo que solo existe por un tiempo muy breve en los albores del sistema planetario, entonces el proceso de formación de planetas debe comenzar muy rápidamente”.

El estudio sugiere que es probable que la imagen de la formación temprana sea correcta, lo que significa que Júpiter y Saturno tuvieron mucho tiempo para crecer hasta sus tamaños actuales.

“Nuestro estudio complementa un creciente consenso en el campo de que la formación de planetas comenzó temprano, con los primeros cuerpos formándose al mismo tiempo que la estrella”, dijo Bonsor. “Los análisis de enanas blancas contaminadas nos dicen que este proceso de fusión radiactiva es un mecanismo potencialmente ubicuo que afecta la formación de todos los planetas extrasolares.

“Esto es solo el comienzo: cada vez que encontramos una nueva enana blanca, podemos recopilar más evidencia y aprender más sobre cómo se forman los planetas. Podemos rastrear elementos como el níquel y el cromo y decir qué tan grande debe haber sido un asteroide cuando formó su núcleo de hierro. Es sorprendente que podamos investigar procesos como este en sistemas exoplanetarios”.

Amy Bonsor es investigadora universitaria de la Royal Society en la Universidad de Cambridge. La investigación fue financiada en parte por la Royal Society, la Fundación Simons y el Consejo Europeo de Investigación.

Referencia:
Amy Bonsor et al. ‘Formación rápida de exoplanetsimales revelada por enanas blancas’. Astronomía de la naturaleza (2022). DOI: 10.1038/s41550-022-01815-8

Las 7 principales tendencias de ciencia de datos para 2023

La ciencia de datos está en constante evolución y se espera que continúe creciendo rápidamente en los próximos años. Incluso ha llevado a la creación de campos dentro de la inteligencia artificial como la visión artificial, el aprendizaje profundo y el procesamiento del lenguaje natural. Hemos analizado las fuentes de tecnología más populares y hemos creado una breve lista de las tendencias más recurrentes en ciencia de datos este año.

Pequeños datos.

El formato y el volumen de los datos pequeños es lo que los hace tan accesibles para las personas, no solo para las máquinas. Allen Bonde define los datos pequeños como lo que «conecta a las personas con información oportuna y significativa (derivada de grandes datos y/o fuentes «locales»), organizada y empaquetada, a menudo visualmente, para que sea accesible, comprensible y procesable para las tareas cotidianas». Esta tendencia probablemente predecirá cómo personalizamos la tecnología y hacemos que los datos funcionen para las personas, en lugar de hacer que las personas trabajen alrededor de los datos.

TinyML.

TinyML es aprendizaje automático que hace que las redes de aprendizaje profundo sean lo suficientemente pequeñas para hardware pequeño. No debería sorprender que TinyML haya sido tendencia debido a la necesidad de que todos tengan un teléfono inteligente y tal vez incluso una tableta. Mantenernos al día con las diferentes plataformas y aplicaciones nos dirá cómo se adaptará el aprendizaje automático para mantener todo un mundo de información al alcance de la mano.

Datos sintéticos.

Estos «datos» falsos creados por un programa informático se utilizan para entrenar modelos de aprendizaje automático. El uso de datos sintéticos puede ahorrarle el tiempo y el dinero necesarios para recopilar las grandes cantidades de datos reales necesarios para entrenar un modelo rápidamente.

Falsificaciones profundas.

Según Exploding Topics, la búsqueda de «deepfake» aumentó un 18 % solo en el último año, con un volumen de 33 100 búsquedas en Google por mes. Con la tendencia cada vez mayor de los jóvenes que aman los filtros SnapChat y TikTok, entrar en la planta baja de las falsificaciones profundas ahora le permitirá hacer que el poder potencial de las falsificaciones profundas funcione para usted en lugar de en su contra.

IA generativa.

Este tipo de IA puede ser no supervisada o semisupervisada en el aprendizaje automático. El algoritmo permite que la computadora use código, contenido y datos para crear versiones completamente nuevas. Este tipo de aprendizaje automático permite que las computadoras comprendan cómo funciona el mundo real y predicen los resultados.

AutoML.

El aprendizaje automático automatizado es exactamente lo que parece. La creciente demanda de AutoML permite que las personas que no tienen conocimientos expertos en aprendizaje automático utilicen programas prefabricados con facilidad.

Analítica aumentada.

Esta tecnología ayudará a preparar datos, brindar información y explicar cómo se pueden analizar y explorar los datos. La automatización ayudará a acelerar y agilizar el proceso de análisis de datos para ayudar a los expertos y ayudar a aclarar al usuario ocasional.

Explore cómo puede hacer que sus datos trabajen más.

El aprendizaje automático y la inteligencia artificial se están desarrollando más rápido y en más formas de las que podríamos imaginar. Estamos viendo muchas tendencias en la tecnología de automatización y aprendizaje automático que pueden ayudarse a sí mismas incluso más que los humanos. Mantenerse al día con estas tendencias de datos y análisis lo ayudará a prepararse para lo que pronto vendrá en 2023.

También puede obtener experiencia en ciencia de datos del mundo real y mantenerse al día con lo último del mundo de la ciencia de datos con el programa Data Scientist Nanodegree.

COMIENZA A APRENDER

Sentirse más pobre que tus amigos en la adolescencia temprana se asocia con una peor salud mental

Los jóvenes que creen que provienen de entornos más pobres que sus amigos tienen más probabilidades de tener una autoestima más baja y ser víctimas de acoso escolar que aquellos que se sienten económicamente iguales al resto de su grupo de pares, según un nuevo estudio de psicólogos de la Universidad. de Cambridge.

El equipo también encontró que aquellos que se consideraban más pobres y aquellos que se creían más ricos eran más propensos a cometer acoso. En general, sentir una sensación de igualdad económica entre tus amigos tuvo los mejores resultados para la salud mental y el comportamiento social.

Si bien la desventaja económica en un amplio espectro de la sociedad se ha relacionado durante mucho tiempo con problemas sociales y de salud mental en los jóvenes, el nuevo estudio es uno de los primeros en mostrar que el simple hecho de sentirse más pobre en comparación con aquellos en su esfera social inmediata puede estar relacionado con problemas negativos. resultados psicológicos.

Según los investigadores, los juicios que hacemos sobre nosotros mismos a través de la «comparación social» en la adolescencia temprana (cuán populares o atractivos creemos que somos, en comparación con los demás) son fundamentales para nuestro floreciente sentido de identidad, y el estado económico percibido puede contribuir a este desarrollo.

«La adolescencia es una época de transiciones, cuando usamos las comparaciones sociales para hacer juicios propios y desarrollar nuestro sentido de identidad», dijo la autora principal del estudio, Blanca Piera Pi-Sunyer, becaria de Cambridge Gates y candidata a doctorado en el Departamento de Psicología de la Universidad.

“Un sentido de nuestra posición económica no solo en la sociedad en general, sino en nuestro entorno inmediato, podría ser problemático para nuestro sentido de pertenencia”, dijo Piera Pi-Sunyer. “La pertenencia es particularmente importante para el bienestar y el funcionamiento psicosocial durante la adolescencia”.

«Nuestra investigación sugiere que las comparaciones de riqueza con quienes nos rodean podrían contribuir a un sentido de autoestima social y personal cuando somos jóvenes».

El último estudio, publicado hoy en la Revista de Psicología y Psiquiatría Infantilfue codirigido por Piera Pi-Sunyer y el Dr. Jack Andrews de la Universidad de Nueva Gales del Sur, como parte de un proyecto de investigación realizado por la psicóloga de Cambridge, la profesora Sarah-Jayne Blakemore.

Los investigadores analizaron la desigualdad económica percibida dentro de los grupos de amistad entre 12.995 niños en el Reino Unido a la edad de 11 años.

Los niños de once años que se creían más pobres que sus amigos puntuaron entre un 6 y un 8 % más bajo en autoestima y un 11 % más bajo en términos de bienestar que aquellos que se consideraban económicamente iguales a sus amigos.

Aquellos que se consideraban menos ricos también tenían más probabilidades de tener «dificultades de internalización», como ansiedad, así como problemas de comportamiento, por ejemplo, problemas de ira o hiperactividad.

Los adolescentes que se ven a sí mismos como más pobres que sus amigos tenían un 17 % más de probabilidades de reportar haber sido intimidados o molestados en comparación con aquellos que se sienten financieramente igual que sus amigos a los 11 años.

Si bien los niveles informados de victimización cayeron en todos los ámbitos cuando los jóvenes cumplieron 14 años, aquellos que se consideraban más pobres tenían un 8% más de probabilidades de ser victimizados que aquellos que se sentían económicamente similares a sus amigos.

Sentirse más rico o más pobre que sus compañeros se relacionó con tasas entre un 3% y un 5% más altas de perpetrar acoso. “Puede ser que sentirse diferente de alguna manera en un momento en que la pertenencia es importante aumente el riesgo de dificultades interpersonales como el acoso escolar”, dijo Piera Pi-Sunyer.

Parte de la investigación de doctorado de Piera Pi-Sunyer analiza los procesos cognitivos detrás de cómo nos vemos a nosotros mismos. Esto incluye cómo la memorización y la internalización de las autocríticas en nuestros primeros años puede guiar la forma en que llegamos a pensar en nosotros mismos, lo que a veces se conoce como ‘autoesquema’.

“Los juicios negativos sobre nosotros mismos pueden sesgarnos para prestar atención a la información que refuerza la falta de autoestima, lo que tiene implicaciones para la salud mental. Vemos que esto bien puede incluir percepciones económicas entre algunos de nuestros grupos de amigos y compañeros durante la adolescencia”, dijo Piera Pi-Sunyer.

Los investigadores utilizaron datos recopilados como parte del Estudio de Cohorte del Milenio (MCS), realizado con miles de jóvenes nacidos entre los años 2000 y 2002. Las encuestas midieron una serie de estados mentales y comportamientos sociales, e incluyeron preguntas sobre el estado económico percibido.

La mayoría de los niños se sentían tan ricos como sus amigos, pero el 4 % y el 8 % se percibían a sí mismos como más pobres o más ricos, respectivamente, que sus amigos (el 16 % dijo que no sabía).

El MCS también recopiló datos sobre el «ingreso familiar objetivo», incluida una medida del ingreso semanal familiar disponible, lo que permitió a los investigadores descontar los efectos de la riqueza real de los padres.

“Muchos estudios sugieren que, objetivamente, los jóvenes de entornos desfavorecidos tienen más dificultades de salud mental. Nuestros hallazgos muestran que la experiencia subjetiva de desventaja también es relevante”, agregó Piera Pi-Sunyer.

“No tienes que ser rico o pobre para sentirte más rico o más pobre que tus amigos, y podemos ver que esto afecta la salud mental de los jóvenes adolescentes”.