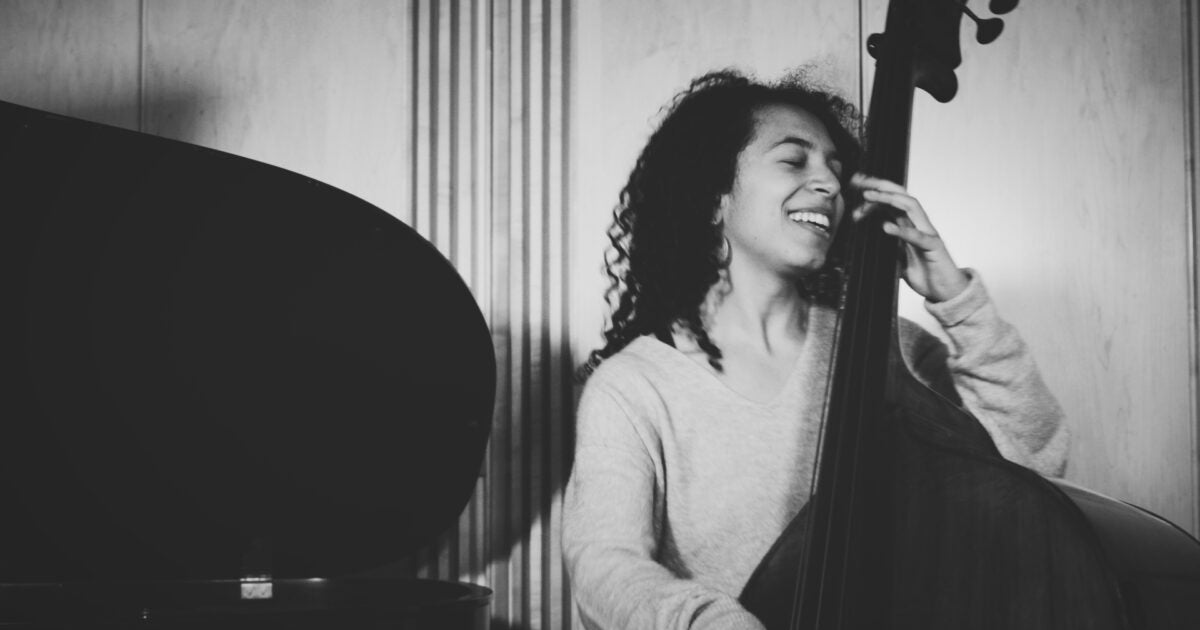
Iyer, un compositor y pianista galardonado y ex miembro de MacArthur, enseñó Gates por primera vez en la primavera de 2020 en una clase de taller que desafiaba a los estudiantes a crear música en conjuntos ad hoc, desarrollando relaciones personales y musicales simultáneamente en tiempo real.
Gates encaja a la perfección con cada grupo al que se unió, aportando dinamismo y una profunda humildad y apoyo como artista, intérprete y cantante, dijo su profesor.
Ella “estaba dispuesta a correr riesgos, que es lo que exige ese formato”, dijo. “Ella no tenía miedo, y creo que eso fue lo más emocionante, que no tenía miedo de subir allí e intentar algo. Si no funcionaba, intentaría algo diferente”.
Durante los últimos dos años, Gates ha trabajado con el Instituto de Jazz y Justicia de Género de Berklee. “Trabajar con el instituto en proyectos especiales que ayudan constructivamente a mejorar las condiciones de nuestra comunidad y poder mezclar todos estos mundos e interactuar realmente con personas y temas que me importan es lo que me atrajo a la antropología”, dijo. “Ya tenía música”.
En el instituto, Gates ha trabajado en una amplia gama de proyectos, incluida la colaboración en la elaboración de un libro de composiciones llamado «New Standards: 101 Lead Sheets by Women Composers», de la autora Terri Lyne Carrington, baterista de jazz, compositora y ganadora de un Grammy. y educador Gates trabajó diligentemente para llegar a los compositores, recopilar grabaciones de audio e intercambiar ideas sobre a quién incluir en el libro. Se incluye su propio trabajo, «Don’t Wait». La colección de partituras principales tiene como objetivo resaltar el importante trabajo de las voces femeninas del jazz, a menudo poco reconocidas.
“Se siente realmente surrealista”. ella dijo. “Amo, respeto y admiro profundamente a todas las mujeres del libro. Haber visto el libro recientemente y ver mi nombre junto a todas estas personas increíbles es una locura, pero también muy inspirador”.
Cuando no está en el Instituto de Jazz y Justicia de Género o actuando en conciertos en todo el país, Gates trabaja con el Proyecto de Estudios de Prisión del Instituto Radcliffe junto con la profesora Kaia Stern. Stern dirige el grupo de trabajo de Música y Justicia que trae instrumentos musicales y un grupo de estudiantes de Harvard todas las semanas a estudiantes adultos encarcelados de la Academia I-Can en la cárcel de Nashua Street en Boston.
“Ha sido genial ir todas las semanas y ver cuánta alegría [you] puede traer [by giving] alguien violó por primera vez y [showing] enseñarles a jugar durante un par de minutos”, dijo. “El impacto que tiene físicamente en alguien es realmente especial”.
Gates dijo que es fundamental conectar su música con diferentes tipos de iniciativas de justicia, inherentes al tipo de música que toca. “La música afroamericana como el jazz, el gospel y el R&B son música de libertad para mí”, dijo. “Para tocar esta música y encarnar esta música, casi te da la responsabilidad de usarla para este tipo de cosas”.
Mientras Gates continuaba tocando su bajo fuera de Winthrop House, Iyer dijo de su aprendiz: «Ha sido asombroso ver cuánto ha evolucionado desde que» tuvieron su primera clase juntos.
Recordó el momento en que Gates jugó sin problemas junto a él en un lugar generalmente habitado por su profesora de Berklee, Linda May Han Oh. Gates no solo tocó el estándar complicado junto a Iyer, sino que también introdujo el canto en la actuación.
“Esa experiencia de tocar con ella, juntar la música, para una actuación de trío, se sintió como estar con colegas”, dijo. “En lo que a mí respecta, ella ya es una de nosotros, y no puedo decir eso de todos”.
La Gaceta Diaria
Regístrese para recibir correos electrónicos diarios para recibir las últimas noticias de Harvard.
La prueba utiliza un ‘nanocebo’ de ADN para detectar los virus respiratorios más comunes, incluidos la influenza, el rinovirus, el RSV y el COVID-19, al mismo tiempo. En comparación, las pruebas de PCR (reacción en cadena de la polimerasa), si bien son altamente específicas y precisas, solo pueden detectar un solo virus a la vez y demoran varias horas en arrojar un resultado.
Si bien muchos virus respiratorios comunes tienen síntomas similares, requieren tratamientos diferentes. Al analizar múltiples virus a la vez, los investigadores dicen que su prueba garantizará que los pacientes reciban el tratamiento adecuado rápidamente y también podría reducir el uso injustificado de antibióticos.
Además, las pruebas se pueden usar en cualquier entorno y se pueden modificar fácilmente para detectar diferentes bacterias y virus, incluidas posibles nuevas variantes del SARS-CoV-2, el virus que causa el COVID-19. Los resultados se publican en la revista Naturaleza Nanotecnología.
La temporada de resfriados invernales, gripe y RSV ha llegado al hemisferio norte, y los trabajadores de la salud deben tomar decisiones rápidas sobre el tratamiento cuando los pacientes se presentan en su hospital o clínica.
“Muchos virus respiratorios tienen síntomas similares pero requieren diferentes tratamientos: queríamos ver si podíamos buscar múltiples virus en paralelo”, dijo Filip Bošković del Laboratorio Cavendish de Cambridge, el primer autor del artículo. “Según la Organización Mundial de la Salud, los virus respiratorios son la causa de muerte del 20% de los niños que mueren antes de los cinco años. Si pudiera crear una prueba que pudiera detectar múltiples virus de forma rápida y precisa, podría marcar una gran diferencia”.
Para Bošković, la investigación también es personal: cuando era niño, estuvo en el hospital durante casi un mes con fiebre alta. Los médicos no pudieron determinar la causa de su enfermedad hasta que se dispuso de una máquina PCR.
“Los buenos diagnósticos son la clave para los buenos tratamientos”, dijo Bošković, estudiante de doctorado en St John’s College, Cambridge. “Las personas se presentan en el hospital que necesitan tratamiento y pueden ser portadoras de múltiples virus diferentes, pero a menos que pueda discriminar entre diferentes virus, existe el riesgo de que los pacientes reciban un tratamiento incorrecto”.
Las pruebas de PCR son potentes, sensibles y precisas, pero requieren que una parte del genoma se copie millones de veces, lo que lleva varias horas.
Los investigadores de Cambridge querían desarrollar una prueba que use ARN para detectar virus directamente, sin necesidad de copiar el genoma, pero con una sensibilidad lo suficientemente alta como para ser útil en un entorno de atención médica.
«Para los pacientes, sabemos que el diagnóstico rápido mejora su resultado, por lo que poder detectar el agente infeccioso rápidamente podría salvarles la vida», dijo el coautor, el profesor Stephen Baker, del Instituto de Inmunología Terapéutica y Enfermedades Infecciosas de Cambridge. “Para los trabajadores de la salud, una prueba de este tipo podría usarse en cualquier lugar, en el Reino Unido o en cualquier entorno de ingresos bajos o medios, lo que ayuda a garantizar que los pacientes reciban el tratamiento correcto rápidamente y reduzcan el uso de antibióticos injustificados”.
Los investigadores basaron su prueba en estructuras construidas a partir de cadenas dobles de ADN con cadenas simples sobresalientes. Estos hilos simples son el ‘cebo’: están programados para ‘pescar’ regiones específicas en el ARN de los virus objetivo. Luego, los nanocebos se pasan a través de agujeros muy pequeños llamados nanoporos. La detección de nanoporos es como un lector de teletipos que transforma estructuras moleculares en información digital en milisegundos. La estructura de cada nanobait revela el virus objetivo o su variante.
Los investigadores demostraron que la prueba se puede reprogramar fácilmente para discriminar entre variantes virales, incluidas las variantes del virus que causa la COVID-19. El enfoque permite una especificidad cercana al 100 % debido a la precisión de las estructuras de nanocebos programables.
“Este trabajo utiliza elegantemente nueva tecnología para resolver múltiples limitaciones actuales de una sola vez”, dijo Baker. “Una de las cosas con las que más luchamos es la identificación rápida y precisa de los organismos que causan la infección. Esta tecnología es un cambio de juego potencial; una plataforma de diagnóstico rápida y de bajo costo que es simple y se puede usar en cualquier lugar con cualquier muestra”.
Cambridge Enterprise, el brazo de comercialización de la Universidad, ha presentado una patente sobre la tecnología, y el coautor, el profesor Ulrich Keyser, ha cofundado una empresa, Cambridge Nucleomics, centrada en la detección de ARN con precisión de una sola molécula.
“Nanobait se basa en la nanotecnología del ADN y permitirá muchas más aplicaciones interesantes en el futuro”, dijo Keyser, que trabaja en el Laboratorio Cavendish. «Para las aplicaciones comerciales y el lanzamiento al público, tendremos que convertir nuestra plataforma de nanoporos en un dispositivo portátil».
“Reunir a investigadores de medicina, física, ingeniería y química nos ayudó a encontrar una solución verdaderamente significativa a un problema difícil”, dijo Bošković, quien recibió un doctorado en 2022 de la Sociedad de Investigación Aplicada de Cambridge por este trabajo.
La investigación fue apoyada en parte por el Consejo Europeo de Investigación, el Programa Winton para la Física de la Sostenibilidad, St John’s College, Investigación e Innovación del Reino Unido (UKRI), Wellcome y el Instituto Nacional de Investigación en Salud y Atención (NIHR) Cambridge Biomedical Research Centro.
Referencia: Filip Boškovic et al. ‘Identificación simultánea de virus y variantes virales con nanocebo de ADN programable.’ Naturaleza Nanotecnología (2022). DOI: 10.1038/s41565-022-01287-x
En estos días, estamos rodeados de pantallas. Pero incluso antes de que los teléfonos y las tabletas se convirtieran en nuestros compañeros constantes, las proyecciones y las imágenes en movimiento capturaron nuestra imaginación. El significado de estas imágenes y cómo las vemos ha interesado durante mucho tiempo a Giuliana Bruno, profesora de Estudios Visuales y Ambientales de Emmet Blakeney Gleason.
En su nuevo libro “Atmospheres of Projection: Environmentality in Art and Screen Media”, considera las interrelaciones de la proyección, la atmósfera y el entorno, reclamando el concepto de “proyección” como una fuerza creativa positiva.
“Me vi obligado a pensar en las imágenes proyectadas porque estamos rodeados por ellas en el arte contemporáneo y en la vida. Tenemos pantallas en todas partes, en los museos y en nuestras casas”, dijo Bruno. “Y pensando en la historia, durante mucho tiempo nos han fascinado las sombras proyectadas por una fuente de luz sobre la superficie de una pared”. Ella se remonta a las pinturas rupestres, «imágenes en las paredes que tenían que ser vistas a la luz de las antorchas», y señala: «La proyección, nacida en la prehistoria, conecta la historia de la humanidad y la historia de la creatividad».
En los últimos tiempos, sin embargo, la idea de “proyección” ha adquirido connotaciones negativas, en gran parte porque el término en psicoanálisis significa la capacidad de desplazar los sentimientos de uno hacia otro. “Esto ha llegado a significar que cualquier cosa negativa desagradable en nosotros mismos puede transferirse a otra persona o a un espacio”, dijo.
Una asociación negativa también se remonta a Platón, cuya alegoría de la caverna convierte la proyección en engaño. “Los presos en la cueva vieron imágenes de personas ‘proyectadas’ en la pared y creyeron que estas sombras eran personas reales”, subrayó Bruno. “Así, se ve que las imágenes proyectan ilusiones”. Desde que la caverna de Platón se convirtió en una metáfora del cine, el espectador se convierte en una persona encerrada en un espacio, mirando pasivamente imágenes falsas e ilusorias proyectadas en las pantallas.
Para Bruno, esta lectura pierde el punto. “En realidad, el término proyección proviene originalmente de la alquimia”, explicó al describir el potencial del proceso proyectivo, a través del cual las sustancias pueden transformarse de una manera deseada y positiva. En su sentido original del siglo XV, la proyección se usaba “para indicar transformación. En alquimia, se refería a la posibilidad de que las materias cambiaran entre sí, afirmando positivamente la metamorfosis como forma de creación”.
Utilizando esta definición, acuñó el término “imaginación proyectiva” para describir una forma de estar abierto al cambio y a nuevas interpretaciones. La proyección nos permite vernos a nosotros mismos como conectados positivamente con otros seres y con el mundo exterior, y sentir este contacto como una energía potencial de transformación.
“Es afirmar la positividad de ser receptivos unos con otros y relacionarnos con nuestro entorno. Es entender que uno se beneficia de este tipo de transferencias entre personas, espacios y cosas”, dijo Bruno. Mirando las transformaciones que ocurren a través de la simpatía y la empatía, o cómo cambian nuestras atmósferas emocionales cuando dejamos entrar a otros, vio la urgencia de redescubrir el significado original de esta antigua palabra.
“Trabajo en estética y tengo una mente filosófica”, dijo. “Pero también me interesa la historia. Y cuando excavas en la historia o la etimología, te das cuenta de que este aspecto transformador estaba allí pero fue desfigurado. Etimológicamente, proyección es un acto de ‘arrojar’. Pero eso se convirtió en tirar, desechar”, dijo, notando las connotaciones negativas de esa frase. “En lugar de desechar, se podría decir que proyectar es una forma de lanzar hacia adelante, de avanzar”. En otras palabras, es un proceso que proyecta posibilidad.
Estas sutiles diferencias lingüísticas son importantes, dijo Bruno. Con la intención de “reimaginar estos conceptos, miro hacia atrás en la historia no solo para ver cómo este concepto de proyección se transformó con el tiempo, sino cómo puede transformar nuestro futuro”, agregó. “Me gustaría cambiar estas nociones para restablecer una política y una estética de la interrelacionalidad que pueda afectar la forma en que vivimos al afirmar la posibilidad y la potencialidad del cambio”.
Las artes, señaló, son clave: “Algunos de los síntomas y potenciales más importantes del cambio cultural y social emergen en las artes hoy en día”. Por ello, la segunda mitad del libro se centra en artistas contemporáneos como la cineasta Chantal Akerman y el artista de instalaciones Robert Irwin. “Interpreto y expongo cómo la imaginación artística está produciendo efectivamente una nueva atmósfera creativa, una nueva atmósfera cultural y una nueva estética”. En otras palabras, nuevas proyecciones.
Cada mes presentaremos a un estudiante de uno de nuestros programas de Nanogrado para mostrar cómo su experiencia con Udacity ha impactado en su vida.
Este mes, hablamos con Ayden, estudiante de segundo año de la universidad a la que le apasiona crear contenido y compartirlo con el mundo. Desde andar en patineta, diseñar una línea de ropa y arte, y más, Ayden sabía que el nanotítulo de marketing digital de Udacity era la opción perfecta para mejorar sus habilidades de marketing y redes sociales.
¿Por qué elegir Udacity?
Me enteré de Digital Marketing Nanodegree a través de la página de becas durante el semestre de primavera de mi primer año. Quería aprender más sobre las redes sociales y el marketing para mi futura carrera. Tuve una conversación con alguien que también se graduó de la beca Udacity. Me impresionó el apoyo brindado y ver su crecimiento educativo y profesional en 3 meses. Me animó a inscribirme para poder hacer lo mismo.
El programa de becas OneTen Nanodegree fue una gran adición a mis estudios porque tenía mentores y una comunidad de compañeros que me hacían responsable de mi progreso. También pude estudiar en mi propio horario, lo cual fue genial para alguien como yo que ya tiene otras prioridades como la escuela, el trabajo y, por supuesto, una vida social.
¿Cómo fue Udacity frente a los estudios universitarios tradicionales?
Udacity y la universidad tradicional tienen dos agendas muy diferentes y tengo la suerte de tener ambas experiencias. Estoy agradecido de tener la capacidad de vivir y trabajar en el campus mientras realizo mis estudios, pero debo decir que es un acto de equilibrar el tiempo.
No todos tienen el tiempo o el presupuesto para inscribirse en un programa en el campus. La razón principal por la que vamos a la escuela es conseguir un trabajo y construir un futuro estable, ¿verdad? Esto por sí solo es mucha presión para algunas personas, ya que hay poco margen para el fracaso. Entonces, en lugar de aprender conceptos y comprender el material, la mayoría de los estudiantes encuentran otras formas de pasar y aprobar. Creo que ese es un problema con la forma en que se configura la universidad, pero con Udacity tendría que decir que es todo lo contrario.
¿Qué piensas de los conceptos prácticos?
Independientemente de si recibe una beca o la paga de su bolsillo, Udacity es excelente porque puede obtener experiencia práctica y completar un programa completo de Nanodegree en solo 3 a 5 meses cortos, que es un semestre de la universidad tradicional. Aprende conceptos del mundo real que son realmente importantes y practicados en su campo, y no es necesario que tome muchos cursos adicionales para hacerlo.
Tal vez soy parcial, pero prefiero al 100% el estilo de aprendizaje de Udacity sobre la universidad porque Udacity quiere verte triunfar. Falla las veces que sea necesario, no importa. El equipo de Udacity está allí para ayudarlo en el camino hasta que finalmente apruebe, donde no solo comprendió realmente los materiales, sino que lo hizo por sí mismo en su propio tiempo.
¿Cómo equilibró sus demandas diarias con su programa Nanodegree?
Soy un estudiante universitario muy ocupado con las clases, el estudio, el trabajo y mis pasatiempos, por lo que es importante para mí planificar mis días. Andar en patineta es mi ejercicio/momento social para liberar el estrés que conlleva la universidad.
Al comienzo de cada semana, reservaba un día completo para completar todo el trabajo de curso de la semana, lo que me daba menos estrés y más tiempo para completar mi trabajo de nanogrado. Mi cohorte estableció reuniones semanales y, si me perdía una, generalmente se grababan y publicaban en nuestro canal de Slack. Al tener el espacio de Slack para visitar las 24 horas del día, los 7 días de la semana, siempre puede encontrar a alguien en línea para obtener ayuda con un proyecto o simplemente con quien chatear. Hice grandes amigos con los que todavía me comunico más de un año después.
¿Cuál fue la parte más desafiante de su programa?
La parte más desafiante de mi programa de Nanogrado fue hacer malabarismos con mi trabajo de Nanogrado durante la semana de exámenes finales. Me gradué del programa Nanodegree justo antes de los exámenes finales, ya que mi carga de trabajo universitario para la escuela era muy pesada. Los plazos de mi trabajo de curso y de nanogrado a menudo se superponían, lo que me daba la oportunidad de practicar mis habilidades de gestión del tiempo.
¿Crees que los conceptos aprendidos se pueden aplicar a tus estudios actuales?
Mi especialidad es la producción de medios, que se relaciona con la creación de películas y contenido. Hay aspectos de esta especialización que requieren un poco de psicología sobre el concepto de público objetivo. Esto fue algo que aprendí en mi Nanogrado antes de aprenderlo en la universidad, así que estaba a la vanguardia.
¿La experiencia de Udacity cambió la forma en que avanzas en tu camino?
Participar en la beca The OneTen me dio la oportunidad de darme cuenta de lo interesado que estoy en seguir una carrera en tecnología/mercadeo, y graduarme de mi Nanogrado solo me ha motivado a seguir adelante. Udacity ha sido el punto de partida de mi viaje de aprendizaje. Estoy emocionado de ver dónde termino en el futuro.
¿Recomendaría Udacity a otras personas y por qué?
Absolutamente, recomendaría Udacity por varias razones. En primer lugar, los programas de nanogrados de Udacity ofrecen a los estudiantes la flexibilidad de trabajar a su propio ritmo, con todos los plazos y expectativas descritos al comienzo del programa.
Luego, hacer nuevos amigos es otra razón, ya que los otros estudiantes de Udacity en tu programa enriquecen la experiencia. A los estudiantes se les asigna una cohorte a la que pueden acudir con preguntas, junto con administradores de la comunidad y mentores que los ayudarán en el camino.
Finalmente, no hay razón para fallar a menos que simplemente no utilice los recursos. Cuando digo que no hay razón para el fracaso, me refiero a que Udacity lo alienta a aprobar y tener éxito. Si se equivoca o no aprueba un proyecto, puede continuar enviando su trabajo hasta que comprenda los conceptos.
¿Alguna vez pensaste en rendirte y por qué no lo hiciste?
Después de mis múltiples presentaciones, tenemos un proyecto que fue un desafío. Mi cohorte y los community managers de Slack me dieron la motivación para seguir adelante. Recuerdo haber sido desafiado y casi me di por vencido, pero después de varias veces de enviar, finalmente aprobé. Honestamente, no hay mejor sensación que ver esa «marca de verificación verde» para aprobar un proyecto.
Su arduo trabajo y dedicación darán sus frutos. No puedes vencer ese sentimiento cuando superas un obstáculo, en cualquier cosa que hagas en la vida. Udacity es un programa que quiere ver ganar a la gente. Agregaré eso como otra razón por la que recomendaría Udacity a otros.
¿Qué consejo le daría a los futuros estudiantes?
¡Diría que el mayor consejo es creer en ti mismo! Sé que suena a cliché, pero el poder de tu mente es fuerte. ¡Cree que lo lograrás y es justo que lo hagas!
Otro consejo es hacer su trabajo antes de las fechas límite, trabajar las lecciones de manera constante durante un par de horas al día y ¡no se estrese por trabajar solo! ¡Tienes una cohorte, un equipo de personas como tú! No dude en hacer preguntas o utilizar el Centro de conocimiento con algo que no entienda.
¿Qué tan pronto después de completar su programa de Nanogrado, pudo poner en práctica los conceptos aprendidos?
Casi tan pronto como me gradué, comencé a usar mi cuenta personal para ver cuánto podía aumentar mi número de seguidores. Lo admito, mirando hacia atrás, ¡ha sido un gran cambio! Con el Nanogrado de Marketing Digital, alguien podría comenzar tan pronto como aprenda los conceptos básicos.
¿Qué le dio el Nanodegree de Marketing Digital la confianza para abordar?
Los conceptos que aprendí a través de The Digital Marketing Nanodegree me han dado confianza para comenzar mi negocio de ropa y arte y finalmente poner todo en línea. Lancé mi negocio y sitio web AYDE Studios, que significa «Todo lo que sueñas existe». Debido a esta experiencia con la beca, definitivamente estoy viviendo mis sueños.
El Nanogrado de Marketing Digital también me ha brindado el conocimiento para comercializar mi obra de arte a través de las redes sociales y cómo leer los análisis. Quién sabe, ¡podría tomar el nanogrado de análisis de marketing a continuación!
Udacity tiene la misión de cambiar la vida de las personas y este programa de becas ha tenido un impacto positivo en la mía. Siempre estaré agradecido de haber tenido esta oportunidad con el programa de becas Udacity/OneTen.
Si tienes la oportunidad de hacer una próxima beca Udacity, no lo dudes porque puede cambiar tu vida.
Esta primavera, los graduados de Harvard tendrán la oportunidad de votar por nuevos miembros de la Junta de Supervisores de Harvard y directores electos de la Asociación de Antiguos Alumnos de Harvard (HAA).
Las elecciones comenzarán el 31 de marzo. Los votantes elegibles pueden votar en línea o en papel. Las boletas completas deben recibirse antes de las 5 p. m. (EDT) del 16 de mayo. Todos los titulares de títulos de Harvard a partir del 1 de enero. 1, excepto los oficiales de instrucción y gobierno de Harvard y los miembros de la Corporación de Harvard, tienen derecho a votar por los candidatos a Supervisor. Todos los titulares de títulos de Harvard a partir del 1 de enero. 1 puede votar por los directores electos de HAA.
Los candidatos que se enumeran a continuación (en orden alfabético) han sido nombrados por el comité de nominaciones designado por el liderazgo voluntario de la Asociación de Antiguos Alumnos de Harvard. Serán considerados por los votantes para cinco vacantes anticipadas en la Junta de Supervisores y para seis vacantes entre los directores electos de HAA.
Candidatos a supervisor
El comité de nominaciones de HAA ha propuesto los siguientes candidatos para las elecciones de 2023:
Sylvia Mathews Burwell AB ’87 BA ’90, Universidad de Oxford Washington DC. Sylvia Mathews Burwell es presidenta de American University y exsecretaria del Departamento de Salud y Servicios Humanos de EE. UU.
Jeffrey D Dunn AB ’77, MBA ’81 Bostón Jeffrey Dunn es presidente interino y director ejecutivo de la Orquesta Sinfónica de Boston y ex presidente ejecutivo, presidente y director ejecutivo de Sesame Workshop.
Arturo Elizondo AB ’14 San Francisco Arturo Elizondo es cofundador y director ejecutivo de The EVERY Company (anteriormente Clara Foods), que busca desbloquear el potencial de las proteínas libres de animales.
Srishti Gupta Narasimhan AB ’97, AM ’97, MD ’03, MPP ’03 Basel, Suiza Srishti Gupta Narasimhan, antes de McKinsey & Co., es directora de la junta de Idorsia Pharmaceuticals y la Fundación Norrsken.
fiona colina AM ’91, doctorado ’98 MA ’89, Universidad de St. Andrews Bethesda, Maryland Fiona Hill, exdirectora sénior del Consejo de Seguridad Nacional para Asuntos Europeos y Rusos, es rectora de la Universidad de Durham (Reino Unido) y miembro sénior de la Institución Brookings.
vanessa w.liu AB ’96, JD ’03 Nueva York, Nueva York Vanessa Liu es fundadora y directora ejecutiva de Sugarwork, una empresa de software que permite el trabajo flexible y la transferencia de conocimientos, y expresidenta de la Asociación de Antiguos Alumnos de Harvard.
Robert L Satcher Jr. MD ’94 SB ’86, Doctorado ’93, Instituto de Tecnología de Massachusetts houston Robert Satcher, exastronauta de la NASA, es profesor asociado de oncología ortopédica en el MD Anderson Cancer Center de la Universidad de Texas.
Luis A. Ubinas AB ’85, MBA ’89 Weston, Vermont Luis Ubiñas es ex presidente de la Fundación Ford y actual presidente de la Estatua de la Libertad – Fundación Ellis Island.
Los candidatos a Supervisor también pueden ser nominados por petición al obtener el número requerido de firmas de los votantes elegibles. La fecha límite para presentar peticiones para la elección de supervisores de 2023 es el 2 de febrero. 1. Puede encontrar más información sobre el proceso de nominación y elección en elecciones.harvard.edu/elections-process.
Candidatos a director electo de HAA
El comité de nominaciones de HAA ha propuesto a los siguientes candidatos a directores electos para las elecciones de 2023:
Bárbara R. Barreno-Paschall año fiscal ’07 JD ’11, Universidad de Vanderbilt; MPP ’17, Universidad de Chicago Vicepresidente y comisionado, Comisión de Derechos Humanos, Estado de Illinois chicago
Rudy N. Brioche MPP ’00 BA ’92, Universidad de Rutgers; JD ’95, Universidad de Maryland Vicepresidente de Políticas Públicas Globales y Asesor de Políticas, Comcast Corporation Alejandría, Virginia
Judith L.Norsigian AB ’70 Director ejecutivo jubilado, Our Bodies Ourselves Chestnut Hill, MA
Yvonne O.Osirim AB ’01, JD ’07 MA ’03, Universidad de Ciudad del Cabo Director ejecutivo, Ética y cumplimiento de la salud humana, Merck Filadelfia
Teodora Skeadas AB ’12, MPP ’16 Asociado de políticas públicas, Twitter Cambridge, MA
Ángela A. Sol AB ’96, JD ’01 Capital de riesgo y director de la junta, Western Union, Cushman & Wakefield y Apollo Strategic Growth Capital Nueva York, Nueva York
Anirudh Suri AMP ’14 BA ’06, Universidad de Haverford; MBA ’12, Universidad de Pensilvania Socio fundador, India Internet Fund y Zanskar Climate Fund Delhi, India
Miya Omori Yamada Ed. M. ’89, Ed.M. ’92, Ed.D. ’93 AB ’88, Smith College Psicólogo de preescolar y primaria, Packer Collegiate Institute Nueva York, Nueva York
Jason W joven AB ’04 Socio Director, Totalmente Humano atlanta
Los candidatos anteriores para supervisor y director electo de HAA surgieron de las deliberaciones del otoño pasado del comité de nominaciones de HAA dirigido por exalumnos. Los miembros con derecho a voto del comité incluyen 13 ex alumnos, muy diversos en sus antecedentes y experiencia, que son designados por el liderazgo voluntario de la HAA. Entre los miembros del comité hay tres Supervisores actuales o recientes, que aportan conocimiento directo del funcionamiento y las necesidades de la Junta.
El comité de nominaciones selecciona candidatos a través de extensas deliberaciones realizadas en una serie de reuniones cada otoño. Al formular sus listas, el comité revisa materiales sobre cientos de posibles candidatos sugeridos por ex alumnos y otros miembros de la comunidad de Harvard.
Al desarrollar una lista diversa de candidatos a Supervisor, teniendo en cuenta la composición actual de la Junta y las necesidades futuras de la Universidad, el comité de nominaciones considera candidatos con servicio anterior en la junta y comprensión de organizaciones complejas; experiencias y logros en un dominio académico o profesional; un amplio interés y preocupación por la educación superior, incluidos los intereses de Harvard y la calidad general y el desarrollo continuo de su misión educativa y de investigación; un compromiso de invertir el tiempo y la energía necesarios para un servicio eficaz; y la capacidad de liderar y generar consenso.
La Junta de supervisores es una de las dos juntas directivas de Harvard, junto con el presidente y los becarios, también conocida como la Corporación. Establecida formalmente en 1642, la junta juega un papel integral en el gobierno de la Universidad. Como parte central de su trabajo, la junta dirige el proceso de visitas, el medio principal para la evaluación externa periódica de las escuelas y departamentos de Harvard. A través de su conjunto de comités permanentes y los aproximadamente 50 comités visitantes que les reportan, la junta evalúa la calidad de los programas de Harvard y asegura que la Universidad se mantenga fiel a su estatuto como lugar de aprendizaje. En términos más generales, aprovechando la experiencia y los conocimientos diversos de sus miembros, la junta brinda asesoramiento al liderazgo de la Universidad sobre prioridades, planes e iniciativas estratégicas. La junta también tiene el poder de consentir ciertas acciones tales como la elección de los miembros de la Corporación. Los miembros actuales de la junta se enumeran aquí.
La Junta de HAA, incluidos sus directores electos, es una junta asesora que tiene como objetivo fomentar un sentido de comunidad, compromiso y ciudadanía universitaria entre los ex alumnos de Harvard en todo el mundo. El trabajo se enfoca en desarrollar el liderazgo voluntario y aumentar y profundizar el compromiso de los ex alumnos a través de una variedad de programas que apoyan a las comunidades de ex alumnos en todo el mundo. En los últimos años, las prioridades de la junta han incluido fortalecer el alcance a los recién graduados y ex alumnos de la escuela de posgrado; apoyar el trabajo contra el racismo en las comunidades de ex alumnos; y continuar construyendo y promoviendo comunidades inclusivas.
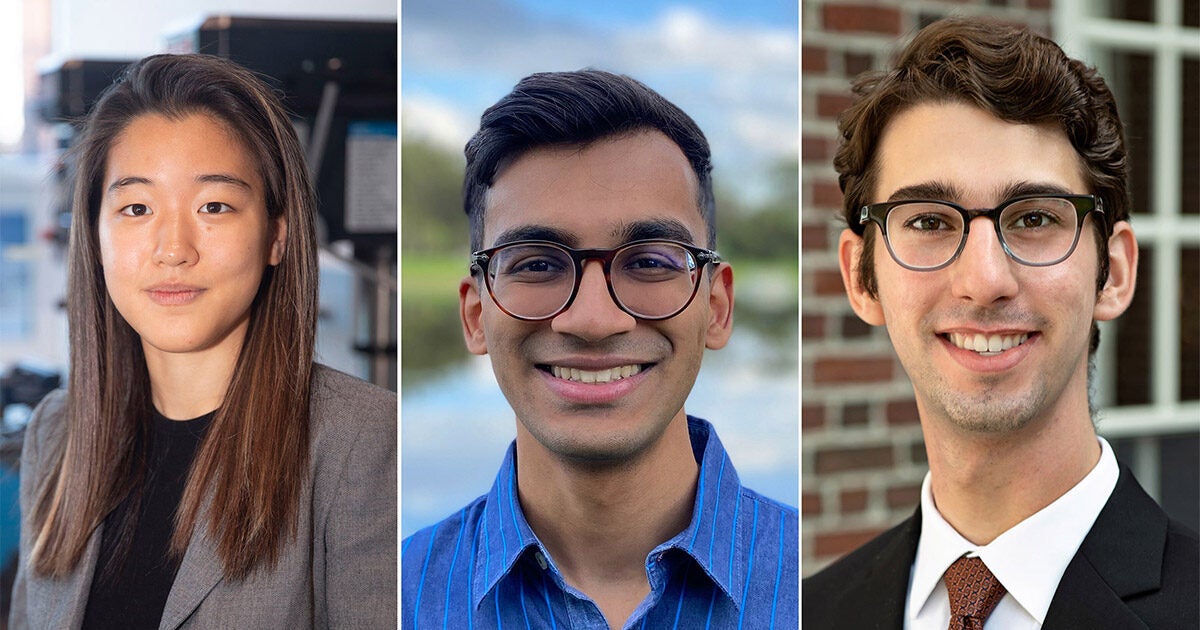
Ciudad natal: Gaithersburg, Maryland Concentración: Aeroespacial y Robótica, Ciencias de la Ingeniería
Como estudiante universitaria de primera generación, Kim está decidida a tener un impacto en las comunidades locales y globales.
“Me siento muy agradecida de tener esta oportunidad, y estoy muy contenta de que haya algunas caras conocidas aquí y que me acompañen en este viaje”, dijo Kim, quien espera que su logro anime a los futuros estudiantes de primera generación. para solicitar becas, becas y estudios de posgrado. “Una de las razones principales por las que realmente quería postularme a esta oportunidad era porque quería ver a más personas como yo representadas en este tipo de becas y becas”.
En el otoño, Kim planea obtener un M.Phil. en informática avanzada con especialización en aprendizaje automático e inteligencia artificial en la Universidad de Cambridge. Su amor e interés por la industria aeroespacial se vio impulsado por su tiempo en Harvard, donde la joven de 21 años es miembro activo del Harvard Satellite Team como ingeniero jefe. Su tiempo con el club y un curso sobre sistemas multi-robot con la profesora asistente de la Escuela de Ingeniería y Ciencias Aplicadas, Stephanie Gil, llevó a Kim a seguir investigando sistemas multi-robot y constelaciones de satélites en el campo aeroespacial.
Kim ha trabajado extensamente en SpaceX, Kayhan Space y MITRE. También continuó desarrollando sus intereses en robótica e informática mientras realizaba investigaciones en el Laboratorio de Microrobótica de Harvard y en el Laboratorio de Sistemas Inteligentes de Stanford.
Ahora que 2022 ha llegado a su fin, es importante reflexionar sobre el año pasado y es emocionante pensar en lo que vendrá en 2023. En general, 2022 fue un gran año para la industria tecnológica. La producción bruta de la industria tecnológica creció un 47 % en el último año, lo que indica que el mercado de datos e información solo está mejorando. ¿Qué significa eso para los trabajadores en 2023? Un montón de increíbles oportunidades de trabajo.
¿Has estado contemplando lanzar una nueva búsqueda de trabajo? Es un buen momento para aprender una nueva habilidad y orientar su carrera hacia la tecnología. Para ayudarlo a decidir qué curso en línea estudiar, echamos un vistazo a la lista de las ocupaciones de más rápido crecimiento de la Oficina de Estadísticas Laborales (BLS) y la comparamos con nuestros programas de nanogrado más populares. Hemos encontrado tres carreras tecnológicas principales que se prevé que crezcan de manera constante a lo largo de 2023: datos, seguridad y desarrollo de software.
En este artículo, le brindaremos todos los detalles sobre esas tres subindustrias, le diremos qué carreras encajan dentro de ellas y lo ayudaremos a encontrar el programa Nanodegree adecuado para comenzar. ¡Saludos al 2023, comencemos!
Desarrollo de software.
El desarrollo de software es un término bastante amplio que podría usarse para describir a cualquier persona, desde un programador principiante hasta un ingeniero de inteligencia artificial (IA). En general, los desarrolladores de software usan código para escribir programas que se ejecutan en una computadora. En un nivel más profundo, muchos desarrolladores de software se especializan en cosas como el desarrollo front-end, la experiencia del usuario, la computación en la nube, la IA, la realidad virtual, las aplicaciones móviles… y la lista continúa.
Datos rápidos del desarrollador de software: Crecimiento del empleo: 26% Salario medio: $ 120,730 Habilidades necesarias: codificación, lenguajes de programación, control de versiones
Aprende a desarrollar software.
Si está interesado en ser ingeniero de software, lo mejor es comenzar aprendiendo a codificar. Puede comenzar con nuestro programa Introducción a la programación de nanogrados. Es una gran base para los principiantes, ya que no hay requisitos previos y todos los que se gradúen de la clase se irán con los conceptos básicos de la codificación y algunos proyectos en su haber. En solo cuatro meses (diez horas a la semana), aprenderá a codificar con HTML, CSS, Python y JavaScript.
Una vez que haya aprendido a programar, puede comenzar a especializar sus habilidades en sus áreas de interés. Consulte el programa Front End Web Developer Nanodegree, el programa Cloud Developer con AWS Nanodegree o el programa AI Programming with Python Nanodegree. Para obtener más opciones, puede consultar nuestro catálogo completo de cursos en nuestra Escuela de Programación para ver qué más despierta su interés.
Seguridad.
A medida que las empresas recopilan y manejan más datos de los clientes, asumen cada vez más riesgos de que se produzca una filtración. Si bien las brechas de seguridad son cada vez más comunes, aún tienen consecuencias importantes para la empresa a la que le suceden, así como para las personas a las que les roban sus datos.
Para mitigar el riesgo de una infracción y al mismo tiempo poder recopilar y manejar datos privados de los clientes, muchas empresas están centrando su atención en desarrollar sus equipos de seguridad. Los roles bajo el paraguas de seguridad incluyen analista de seguridad, arquitecto de seguridad, ingeniero de seguridad, ingeniero de DevOps e incluso hacker ético.
Datos rápidos de seguridad: Crecimiento del empleo: 34,7% Salario promedio: $102,600 Habilidades necesarias: arquitectura de sistemas, redes, seguridad informática
Cómo aprender sobre ciberseguridad.
Si recién está comenzando en el ámbito de la ciberseguridad, es mejor comenzar con lo básico. El programa Introducción a la ciberseguridad Nanodegree dura aproximadamente 4 meses con 10 horas a la semana. Cubre habilidades tales como evaluación de riesgos, vulnerabilidades, técnicas de encriptación y los fundamentos de Gobernanza, Riesgo y Cumplimiento (GRC).
Una vez que haya completado los fundamentos de la ciberseguridad, puede pasar a cursos más especializados, como el programa Security Analyst Nanodegree, el programa Security Engineer Nanodegree, el programa Security Architect Nanodegree o el programa Ethical Hacker Nanodegree.
Cada uno de estos programas asume una parte diferente del trabajo de seguridad, desde el diseño de sistemas hasta encontrar sus fallas. Para obtener más opciones, puede consultar nuestro catálogo completo de cursos de ciberseguridad en nuestra Escuela de Ciberseguridad para ver qué más despierta su interés.
Datos.
En estos días, parece que los datos son más valiosos que la moneda misma. Las empresas ofrecerán sus bienes y servicios de forma gratuita a cambio del acceso a los datos de sus clientes. Sin embargo, el problema es que estas empresas necesitan desesperadamente personas que tengan habilidades en datos para poder capturar, filtrar y analizar los datos. Estos roles van desde ingeniero de datos hasta analista de datos. Todos estos roles están creciendo a un ritmo increíblemente alto y solo a partir de aquí.
Hechos de datos rápidos: Crecimiento del empleo: 35,8% Salario promedio: $100,910 Habilidades necesarias: análisis de datos, recopilación de datos, visualización de datos, estadísticas
Aprenda a capturar, filtrar y analizar datos.
Para comenzar una carrera en datos, recomendamos tomar el programa Programación para ciencia de datos con Python Nanodegree. No hay requisitos previos para este curso y proporciona una base fantástica para hacer crecer su carrera de datos. Los graduados de este programa de Nanodegree aprenderán los fundamentos de las herramientas críticas para el trabajo de datos, como Python, SQL, git y la línea de comandos.
Después de obtener una base con el programa de nanogrado de programación para ciencia de datos, recomendamos que las personas tomen el siguiente nivel de cursos como el programa de nanogrado de analista de datos, el programa de nanogrado de científico de datos o el programa de ingeniería de datos con nanogrado de AWS. ¡Uno (o todos) de estos cursos lo ayudarán a elegir qué carrera de datos es adecuada para usted!
Para obtener más opciones, puede consultar nuestro catálogo completo de cursos de datos en nuestra Escuela de ciencia de datos para ver qué más despierta su interés.
Únase a la industria de más rápido crecimiento en 2023.
Si está buscando una nueva carrera, o si simplemente desea mejorar su currículum actual para dar el siguiente paso en su trabajo, agregar nuevas habilidades en tecnología es una forma segura de pasar al siguiente nivel.
Explore nuestro catálogo completo de cursos y descubra dónde encaja usted en el mundo de la tecnología.
«Pensamos que esta era una oportunidad única para comprender lo que Exxon sabía sobre este tema y qué nivel de comprensión científica tenían en ese momento», agregó la coautora Naomi Oreskes, profesora de Historia de la ciencia Henry Charles Lea, cuyo trabajo analiza la Causas y efectos de la negación del cambio climático. «Descubrimos que sus pronósticos no solo eran extremadamente hábiles, sino que a menudo eran más hábiles que los pronósticos realizados por académicos independientes y científicos gubernamentales al mismo tiempo».
Las denuncias de que los ejecutivos de las compañías petroleras trataron de engañar al público sobre el papel de la industria en el cambio climático han atraído un escrutinio cada vez mayor en los últimos años, incluidas las demandas de varios estados y ciudades y una reciente investigación de alto perfil del comité de la Cámara de Representantes de EE. UU.
Los científicos de Harvard utilizaron técnicas estadísticas establecidas por el Panel Intergubernamental sobre el Cambio Climático (IPCC) para probar el rendimiento de los modelos de Exxon. Descubrieron que, según la métrica utilizada, entre el 63 y el 83 por ciento de las proyecciones de calentamiento global informadas por los científicos de Exxon coincidían con las temperaturas reales a lo largo del tiempo. Además, las propias proyecciones de la corporación tenían un “puntaje de habilidad” promedio de 72 por ciento, más o menos 6 por ciento, con el puntaje más alto de 99 por ciento. Un puntaje de habilidad se relaciona con qué tan bien se compara un pronóstico con lo que sucede en la vida real. A modo de comparación, las predicciones sobre el calentamiento global del científico de la NASA James Hansen presentadas ante el Congreso de los Estados Unidos en 1988 tenían puntuaciones del 38 al 66 por ciento.
Resumen de todas las proyecciones de calentamiento global informadas por los científicos de ExxonMobil en documentos internos entre 1977 y 2003 (líneas grises), superpuestas al cambio de temperatura observado históricamente (rojo). Las líneas grises sólidas indican proyecciones de calentamiento global modeladas por los propios científicos de ExxonMobil; las líneas grises discontinuas indican proyecciones reproducidas internamente por científicos de ExxonMobil a partir de fuentes de terceros. Tonos de escala de grises con fechas de inicio del modelo, desde la más temprana (1977: más clara) hasta la más reciente (2003: más oscura).
Los investigadores informan que los científicos de Exxon descartaron correctamente la posibilidad de una próxima edad de hielo, predijeron con precisión que el calentamiento global causado por el hombre sería detectable por primera vez en el año 2000, más o menos cinco años, y estimaron razonablemente cuánto CO2 conduciría a un calentamiento peligroso.
El debate actual sobre cuándo Exxon supo sobre el impacto en las emisiones de carbono del cambio climático comenzó en 2015 luego de informes de noticias de documentos internos de la compañía que describen los primeros conocimientos de la multinacional sobre la ciencia del clima. Exxon no estuvo de acuerdo con los informes, incluso proporcionó un enlace a estudios internos y memorandos de sus propios científicos y sugirió que las partes interesadas deberían leerlos y tomar sus propias decisiones.
“Eso es exactamente lo que hicimos”, dijo Supran, quien ahora está en la Universidad de Miami. Juntos, él y Oreskes pasaron un año investigando esos documentos y en 2017 publicaron una serie de tres artículos que analizan los 40 años de historia de las comunicaciones climáticas de Exxon. Pudieron demostrar que había una discrepancia sistemática entre lo que Exxon decía internamente y en los círculos académicos y lo que decía al público. “Eso nos llevó a concluir que habían engañado cuantificablemente al público, esencialmente contribuyendo silenciosamente a la ciencia del clima y, sin embargo, promoviendo en voz alta la duda sobre esa ciencia”, dijo Supran.
Cuando se trabaja con datos, ya sea para análisis o aplicaciones de ciencia de datos, un paso clave en la canalización de ETL es la transformación de datos. La transformación de datos con Python es una habilidad esencial para los ingenieros de datos que incluye tres amplias categorías: manipular la forma de los datos; características de ingeniería en los datos; y transformar valores de datos.
La biblioteca de Python Pandas contiene una amplia variedad de funciones para manipular datos, incluidas herramientas para lograr los tres tipos de transformaciones.
En este artículo, revisaremos lo que significa cada una de las tres categorías de transformación y luego veremos ejemplos en Python usando Pandas.
¿Qué es transformar datos?
Tanto los procesos ETL como ELT tienen la letra «T» que significa «transformación». Durante el paso de transformación, el ingeniero de datos realizará tres categorías de transformaciones:
1. Manipular la forma de los datos
Este tipo de transformación de datos es una oportunidad para formar los datos de manera que sean adecuados para un propósito previsto. Ejemplos específicos pueden ser reordenar y seleccionar filas; renombrar y seleccionar columnas; eliminando valores duplicados; o el manejo de valores faltantes.Además, las transformaciones a gran escala pueden incluir el cambio de un formato ancho a largo o largo a ancho.
El objetivo es tener un conjunto de datos listos para ser analizados, ya sea en un informe, un modelo estadístico o un modelo de aprendizaje automático.
2. Funciones de ingeniería en los datos
Este tipo de transformación de datos genera nuevos valores de datos basados en valores existentes. Este es un paso importante para muchos ejercicios avanzados de modelado estadístico y de aprendizaje automático. Los ejemplos de ingeniería de características incluyen la creación de nuevas variables; reemplazando valores; o combinar o dividir valores.
El objetivo es generar columnas de datos apropiadas para ayudar a un estadístico aplicado o ingeniero de aprendizaje automático a crear modelos eficientes y efectivos para responder preguntas explícitas sobre los datos.
3. Transformar valores de datos
El último tipo de transformación de datos consiste en modificar los valores de los datos para crear una distribución adecuada para el análisis. Por ejemplo, un conjunto de valores en un conjunto de datos puede estar severamente sesgado o escalado de manera inconsistente. Los ejemplos de transformación de valores de datos incluyen transformaciones logarítmicas, de raíz cuadrada o cúbica; estandarización o normalización de datos; o eliminación de valores atípicos.
El objetivo es crear valores de datos adecuados para varios algoritmos estadísticos y de aprendizaje automático.
Cómo transformar datos con Python usando Pandas.
Pandas es una importante biblioteca de Python para todas las tareas de transformación de datos. La biblioteca contiene una amplia variedad de herramientas para manipular datos. En las siguientes secciones, verá una variedad de funciones con las que todo ingeniero de datos debería sentirse cómodo.
Los ejemplos de código a continuación utilizarán este archivo de datos: student_data.csv, que es un conjunto de datos falso para los fines de este artículo. Este código leerá los datos en una variable llamada df que se usará a lo largo de este artículo. Para algunas transformaciones, crearemos una copia del marco de datos solo por conveniencia.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

df = pd.read_csv("student_data.csv")
display(df)
Cómo manipular la forma de los datos.
Cambiar la forma de los datos es uno de los casos de uso más comunes cuando se transforman datos usando Python. A menudo, los datos sin procesar deben formarse, remodelarse o limpiarse para que los utilice un analista de datos o un científico de datos.
Ordenar y filtrar
A menudo, el orden de los datos es importante, especialmente cuando se inspeccionan conjuntos de datos manualmente. Además, puede ser útil filtrar el conjunto de datos y usar solo filas o columnas de datos particulares. Para ello, utilizaremos las siguientes funciones de pandas: sort_values, queryy filter.
#Sort by name
sorted = df.sort_values(by=['name'])
display(sorted)
Un desafío común con los conjuntos de datos sin procesar son las filas de datos duplicadas. Alternativamente, puede haber filas con solo datos parciales. Ambas condiciones pueden generar conclusiones no válidas de los modelos estadísticos y de aprendizaje automático.
El siguiente código muestra cómo encontrar y eliminar filas duplicadas usando el duplicated y drop_duplicates funciones Además, vemos una técnica para manejar valores perdidos llamada «eliminación por lista» usando el dropna función. Primero, usaremos el isna función para encontrar valores faltantes. Tenga en cuenta que el manejo de los datos faltantes es un tema amplio y, por brevedad, solo cubrimos este método, pero hay muchas otras formas de manejar los valores faltantes en un conjunto de datos.
A veces, un conjunto de datos sin procesar tendrá nombres de columna que tienen sentido para el propietario original de los datos, pero pueden no tener sentido en un sentido analítico más amplio. La función de cambio de nombre nos permite cambiar los nombres de las columnas a algo más apropiado para el analista de datos o el científico de datos.
Los conjuntos de datos se pueden formatear en formato ancho o largo. Los formatos anchos son conjuntos de datos que contienen medidas o valores repetidos en una sola fila. Por ejemplo, un solo registro puede contener valores para los cuatro trimestres de un año en cuatro columnas separadas. Los formatos largos repetirán las columnas de identificación (id, nombre, etc.) y luego agregarán las medidas repetidas en su propia fila, de modo que cada trimestre tenga su propia fila. Cambiando de ancho a largo podemos usar el melt función y de largo a ancho podemos usar el pivot función.
#Wide to long
long = pd.melt(dups_removed, id_vars=['participant_id', 'name'], value_vars=['Q1','Q2','Q3','Q4'], var_name="quarter", value_name="clicks")
display(long)
La ingeniería de características es el proceso de transformar datos sin procesar en características que se pueden usar en el modelado.
Por ejemplo, los datos sin procesar pueden contener un conjunto de valores continuos, pero para su modelo, solo necesita saber si el valor está por encima de cierto umbral. Puede diseñar una función llamada «exceeds_threshold» que contiene un 1 o un 0 según la condición.
Los ejemplos de código a continuación continuarán usando el mismo conjunto de datos que usamos en la sección anterior.
Nuevas variables
Otro ejemplo común de creación de una nueva variable es cuando un conjunto de datos contiene fechas de nacimiento. Una característica más útil podría ser la «edad» en lugar de usar la fecha de nacimiento sin procesar. El siguiente código primero crea una función para calcular la edad y luego crea una nueva columna para contener estos datos.
#New Variable
from dateutil.relativedelta import *
from datetime import *

def get_age(dob):
    now = datetime.now()
    age = relativedelta(now, dob).years
    return age

df['age'] = pd.to_datetime(df['dob']).apply(get_age)

display(df)
Reemplazar valores
A veces, los valores en un conjunto de datos deben reemplazarse con algo más (o menos) significativo. En el siguiente ejemplo, estamos ofuscando el apellido de la persona usando una expresión regular para reemplazar todo lo que está después del espacio con ‘APELLIDO’.
A menudo, cuando se trabaja con columnas de texto, los datos deben dividirse o combinarse de varias formas. El siguiente código demuestra cómo la columna de nombre se puede dividir en nombre y apellido. El siguiente bloque de código muestra cómo recombinar el nombre y el apellido usando la convención ‘apellido, primero’.
A menudo, los estadísticos aplicados y los ingenieros de aprendizaje automático necesitan que los valores numéricos de los datos se transformen para respaldar mejor las suposiciones de los modelos seleccionados. Además, muchos modelos necesitan datos que se escalan adecuadamente para el análisis.
Del conjunto de datos que hemos estado usando, veamos la distribución de la columna de destino.
#Data Value transforms
df['target'].hist()
Podemos ver que estos datos no se ajustan a una distribución normal, que es una suposición común para muchos modelos. En las siguientes secciones, veremos algunas transformaciones comunes para ver si podemos transformar este conjunto de datos en una distribución más adecuada.
Transformaciones de distribución
El siguiente código muestra varias transformaciones de distribución diferentes y la forma resultante de la nueva distribución.
El siguiente código muestra una transformación de registro de los datos anteriores. Por lo general, usaríamos una transformación de registro para datos sesgados a la derecha en lugar de datos sesgados a la izquierda y vemos que el efecto es el opuesto al que nos gustaría, ya que aumenta la asimetría.
Por el contrario, el siguiente código usa una transformación de cubo que da como resultado menos sesgo en los datos resultantes. Esto puede o no ser aceptable según el modelo que se utilice, por lo que un ingeniero de datos deberá trabajar con el científico de datos para encontrar la mejor solución. Por lo general, se puede usar alguna combinación de transformaciones logarítmicas, raíces o de potencia para remodelar una distribución.
Cuando se trabaja con columnas de datos que tienen unidades o escalas variables, existen dos métodos principales para escalar los datos para que las columnas se puedan comparar razonablemente.
Normalización de datos transforma cada valor a un valor entre 0 y 1.
Estandarización de datos transforma cada valor de modo que la distribución tenga una media de 0 y una desviación estándar de 1.
Ambas formas de escalado tienen funciones especiales construidas en Python en scikitlearn para hacer esto; sin embargo, el siguiente código muestra cómo hacer estas transformaciones usando solo numpy.
La transformación de datos con Python es una habilidad fundamental para cualquier ingeniero de datos en un entorno de ciencia de datos moderno. En este artículo, explicamos qué significa transformar datos, incluidas tres categorías diferentes de transformación de datos, y luego exploramos ejemplos de cada uno de estos tipos de transformación de datos.
¿Quiere realmente llevar sus habilidades de ingeniería de datos al siguiente nivel? El programa Programación para ciencia de datos con Python Nanodegree es su próximo paso. Te enseñaremos a trabajar en el campo de la ciencia de datos utilizando las herramientas fundamentales de programación de datos: Python, SQL, línea de comandos y git.
Se estima que alrededor de 415 millones de personas en todo el mundo viven con diabetes tipo 2, lo que cuesta alrededor de $ 760 mil millones en gastos sanitarios mundiales anuales. Según Diabetes UK, solo en el Reino Unido, más de 4,9 millones de personas tienen diabetes, de las cuales el 90% tiene diabetes tipo 2, y se estima que esto le cuesta al NHS £ 10 mil millones por año.
La diabetes tipo 2 hace que los niveles de glucosa (azúcar en la sangre) sean demasiado altos. Por lo general, los niveles de azúcar en la sangre están controlados por la liberación de insulina, pero en la diabetes tipo 2 se interrumpe la producción de insulina. Con el tiempo, esto puede causar problemas graves, como daños en los ojos, los riñones y los nervios, y enfermedades cardíacas.
La enfermedad generalmente se maneja a través de una combinación de cambios en el estilo de vida (mejor dieta y más ejercicio, por ejemplo) y medicamentos, con el objetivo de mantener bajos los niveles de glucosa.
Investigadores del Instituto Wellcome-MRC de Ciencias Metabólicas de la Universidad de Cambridge han desarrollado un páncreas artificial que puede ayudar a mantener niveles saludables de glucosa. El dispositivo combina un monitor de glucosa estándar y una bomba de insulina con una aplicación desarrollada por el equipo, conocida como CamAPS HX. Esta aplicación funciona con un algoritmo que predice cuánta insulina se requiere para mantener los niveles de glucosa en el rango objetivo.
Los investigadores han demostrado previamente que un páncreas artificial ejecutado por un algoritmo similar es efectivo para pacientes que viven con diabetes tipo 1, desde adultos hasta niños muy pequeños. También han probado con éxito el dispositivo en pacientes con diabetes tipo 2 que requieren diálisis renal.
Hoy, en Nature Medicine, el equipo informa sobre la primera prueba del dispositivo en una población más amplia que vive con diabetes tipo 2 (que no requiere diálisis renal). A diferencia del páncreas artificial utilizado para la diabetes tipo 1, esta nueva versión es un sistema de circuito completamente cerrado, mientras que los pacientes con diabetes tipo 1 necesitan decirle a su páncreas artificial que están a punto de comer para permitir el ajuste de la insulina, por ejemplo, con esta versión. pueden dejar que el dispositivo funcione de forma completamente automática.
Los investigadores reclutaron a 26 pacientes de la Clínica de Endocrinología y Diabetes Wolfson en el Hospital Addenbrooke, parte del Fideicomiso de la Fundación NHS de los Hospitales de la Universidad de Cambridge, y un grupo local de cirugías de médicos de cabecera. Los pacientes fueron asignados aleatoriamente a uno de dos grupos: el primer grupo probaría el páncreas artificial durante ocho semanas y luego cambiaría a la terapia estándar de múltiples inyecciones diarias de insulina; el segundo grupo tomaría primero esta terapia de control y luego cambiaría al páncreas artificial después de ocho semanas.
El equipo utilizó varias medidas para evaluar la eficacia con la que funcionaba el páncreas artificial. El primero fue la proporción de tiempo que los pacientes pasaron con sus niveles de glucosa dentro de un rango objetivo de entre 3,9 y 10,0 mmol/L. En promedio, los pacientes que usaron el páncreas artificial pasaron dos tercios (66 %) de su tiempo dentro del rango objetivo, el doble mientras estaban en el control (32 %).
Una segunda medida fue la proporción de tiempo pasado con niveles de glucosa por encima de 10,0 mmol/L. Con el tiempo, los niveles altos de glucosa aumentan el riesgo de complicaciones potencialmente graves. Los pacientes que tomaron la terapia de control pasaron dos tercios (67 %) de su tiempo con niveles altos de glucosa; esto se redujo a la mitad al 33 % cuando se usó el páncreas artificial.
Los niveles promedio de glucosa cayeron: de 12,6 mmol/L al tomar la terapia de control a 9,2 mmol/L al usar el páncreas artificial.
La aplicación también redujo los niveles de una molécula conocida como hemoglobina glicosilada o HbA1c. La hemoglobina glucosilada se desarrolla cuando la hemoglobina, una proteína dentro de los glóbulos rojos que transporta el oxígeno por todo el cuerpo, se une a la glucosa en la sangre y se ‘glucosa’. Al medir la HbA1c, los médicos pueden obtener una imagen general de cuáles han sido los niveles promedio de azúcar en la sangre de una persona durante un período de semanas o meses. Para las personas con diabetes, cuanto mayor sea la HbA1c, mayor será el riesgo de desarrollar complicaciones relacionadas con la diabetes. Después de la terapia de control, los niveles promedio de HbA1c fueron del 8,7 %, mientras que después de usar el páncreas artificial fueron del 7,3 %.
Ningún paciente experimentó niveles de azúcar en sangre peligrosamente bajos (hipoglucemia) durante el estudio. Un paciente ingresó en el hospital mientras usaba el páncreas artificial debido a un absceso en el sitio de la cánula de la bomba.
La Dra. Charlotte Boughton del Instituto Wellcome-MRC de Ciencias Metabólicas de la Universidad de Cambridge, quien codirigió el estudio, dijo: “Muchas personas con diabetes tipo 2 luchan por controlar sus niveles de azúcar en la sangre usando los tratamientos disponibles actualmente, como la insulina. inyecciones El páncreas artificial puede proporcionar un enfoque seguro y eficaz para ayudarlos, y la tecnología es fácil de usar y se puede implementar de manera segura en el hogar”.
La Dra. Aideen Daly, también del Instituto Wellcome-MRC de Ciencias Metabólicas, dijo: “Una de las barreras para el uso generalizado de la terapia con insulina ha sido la preocupación por el riesgo de ‘hipo’ severas: niveles de azúcar en sangre peligrosamente bajos. Pero descubrimos que ningún paciente en nuestro ensayo experimentó estos y los pacientes pasaron muy poco tiempo con niveles de azúcar en la sangre más bajos que los niveles objetivo».
Los comentarios de los participantes sugirieron que los participantes estaban contentos de que el sistema controlara automáticamente sus niveles de glucosa, y nueve de cada diez (89 %) informaron pasar menos tiempo controlando su diabetes en general. Los usuarios destacaron la eliminación de la necesidad de inyecciones o pruebas de punción digital y una mayor confianza en el control de la glucosa en sangre como beneficios clave. Las desventajas incluyeron una mayor ansiedad por el riesgo de hipoglucemia, que según los investigadores puede reflejar una mayor conciencia y control de los niveles de glucosa, y molestias prácticas con el uso de dispositivos.
El equipo ahora planea llevar a cabo un estudio multicéntrico mucho más grande para aprovechar sus hallazgos y ha presentado el dispositivo para la aprobación regulatoria con el fin de que esté disponible comercialmente para pacientes ambulatorios con diabetes tipo 2.
La investigación fue apoyada por el Centro de Investigación Biomédica de Cambridge del Instituto Nacional para la Investigación de la Salud y la Atención (NIHR).
Referencia Daly, AB, Boughton, CK, et al. Administración de insulina de circuito cerrado completamente automatizada en adultos con diabetes tipo 2: un ensayo cruzado aleatorizado abierto de un solo centro. NatMed; 11 de enero de 2023; DOI: 10.1038/s41591-022-02144-z
En las últimas dos publicaciones, Master C++ Copy Semantics y Inside Lvalues & Rvalues in C++, analizamos algunos conceptos elementales que son importantes para una comprensión sólida de la semántica de Move.
En esta tercera publicación, veremos en detalle las referencias de Rvalue, también conocidas como identificadores para valores temporales. Tal concepto puede parecer relativamente trivial a primera vista, pero de hecho, es el mecanismo que hace posible la semántica de Move y las ideas detrás de ella en primer lugar. Echemos un vistazo a por qué esto es así.
¿Qué son las referencias RValue?
En el segundo post ya aprendimos sobre los Rvalues como valores temporales que se usan para inicializar variables, por ejemplo. Los valores R no son accesibles para nosotros a través de su propia dirección, aunque son un objeto en la memoria al igual que los valores L. Aquí, en el ejemplo, la variable k es un valor L y el 5 en el lado derecho del operador de asignación es un valor R.
C++11 introdujo la referencia Rvalue por primera vez, que es una herramienta que nos permite obtener acceso permanente a objetos temporales en la memoria. Las referencias de Rvalue funcionan en principio de manera similar a las referencias de Lvalue: las declaramos escribiendo el tipo de datos del rvalue seguido de && y un identificador. Luego, como se muestra en el ejemplo, podemos usar el operador de asignación para conectar el valor r 42 a la referencia j:
Una vez que se completa la asignación, tenemos acceso de lectura y escritura a la ubicación de la memoria donde se almacena el número 42. Básicamente, hemos convertido el Rvalue temporal 42 en un Lvalue j permanente que existe mientras la referencia Rvalue sea válida.
Una de las ideas principales detrás de las referencias de Rvalue es hacer que las asignaciones sean más eficientes al guardar las operaciones de copia. Lo mejor es ver cómo funciona una asignación normal sin referencias Rvalue.
En el ejemplo, la suma de dos variables k y l se asigna a una variable m. Todas las variables son valores l, pero la suma k + l es un valor r porque el operador de suma devuelve el resultado solo temporalmente y sin identificador.
La instrucción del ejemplo se puede dividir en cuatro pasos individuales:
En el primer paso, el lvalue m se crea en la memoria.
Se calcula la suma k + l y el resultado también se almacena en la memoria, pero como un valor R.
Este valor temporal luego se copia en la dirección de m. Por un breve momento, el valor existe el doble y, por lo tanto, consume el doble de memoria. 4.
Posteriormente, el valor temporal se libera nuevamente y el sistema puede eliminarlo.
Una asignación de valor simple genera dos objetos en la memoria, una operación de copia y una operación de eliminación. Ahora veamos lo mismo nuevamente con una referencia Rvalue en lugar de un Lvalue.
Una de las grandes ventajas de las referencias Rvalue es que ahorran operaciones de copia a la hora de asignar valores. La idea es utilizar el resultado de, por ejemplo, una operación de suma directamente sin tener que copiar el valor. El ejemplo muestra el principio:
Primero, se crea una referencia Rvalue n en la memoria. El operador de suma luego calcula la suma de los dos valores de l k y l, y luego la dirección del resultado temporal se asigna a n sin copiar el valor real. En comparación con la asignación de valor convencional Rvalue a Lvalue, ahorramos memoria, una operación de copia y una operación de eliminación. En general, la cantidad de ahorro es proporcional al tamaño del tipo de datos.
En el código, las referencias de Rvalue se pueden usar como identificadores regulares y, por lo tanto, Lvalues para acceder a los objetos anteriormente temporales en la memoria.
Ya hemos visto, entre otras cosas, en la semántica de copia que las referencias de Lvalue se pueden usar de manera muy efectiva como parámetros de función. Por lo tanto, ahorramos operaciones de copia al pasar argumentos creando un alias local en su lugar. El alias se puede usar para acceder directamente al argumento en el original desde dentro de la función.
Lo mismo funciona con referencias rvalue. Si pasamos un Rvalue como argumento en lugar de un Lvalue, ya no se copiará, pero también se creará un alias. Podemos acceder a la memoria a través del alias y leer o escribir.
En el lado de la llamada, la llamada se vería así, por ejemplo:
Aquí pasamos el Rvalue 42 a la función passValue(). La principal diferencia con las referencias de Lvalue es que en el lado de la llamada de función, es decir, en main(), el Rvalue ya no es necesario. Solo está disponible dentro de la función a la que se la pasamos. Entonces, podemos usar referencias de rvalue para hacer que pasar rvalues a funciones sea más eficiente, porque al igual que con las referencias de lvalue, no necesitamos copiar los argumentos.
Entonces, al igual que las referencias Lvalue, las referencias Rvalue nos ofrecen una forma de aumentar la eficiencia. Ahora veamos por qué, además, también forman la base de la semántica Move: la idea básica de la semántica Move es evitar costosos copia profunda operaciones y utilice operaciones de movimiento más baratas en su lugar.
Justo ahora vimos que las referencias Lvalue y las referencias Rvalue son casi lo mismo: nos proporcionan un alias para un valor de memoria y guardan una operación de copia. En la parte práctica veremos en un momento que no podemos asignar un rvalue a una referencia lvalue y un lvalue a una referencia rvalue. Si escribimos una función que debería poder hacer ambas cosas, entonces tenemos que sobrecargarla en consecuencia (es decir, escribir dos variantes de la misma) con una referencia de valor l y una referencia de valor r como parámetros.
El compilador puede notar la diferencia y llama a la variante correcta según el argumento pasado. Esta capacidad de distinguir entre lvalues y rvalues es el principio básico por el cual funciona la semántica de movimiento: tenemos la posibilidad de detectar objetos temporales, es decir, Rvalues, y así tratarlos de manera diferente dentro de una función que Lvalues.
En la parte práctica, ahora veremos algunos ejemplos de referencias de Rvalue antes de implementar las operaciones de movimiento reales en la próxima publicación.
RValue referencias en la práctica.
Hasta ahora hemos aprendido acerca de la referencia Rvalue como contraparte de la referencia Lvalue, es decir, como un identificador de alias para objetos (temporales). Sin embargo, antes de adentrarnos en el significado de la referencia Rvalue para la semántica de movimientos, el punto aquí es conocer las reglas del juego cuando se usa esta construcción en la práctica.
Experimento 1
En el primer experimento, queremos ver la diferencia entre las referencias Lvalue y las referencias Rvalue. Para hacer esto, primero creamos un Lvalue en Listado 16es decir, una variable i de tipo entero (→//1).
Luego creamos una referencia lvalue llamada lv_ref y la vinculamos a i. Es importante tener en cuenta que la referencia debe tener el mismo tipo de datos que la variable. Como se puede ver en la línea comentada, no se pueden asignar valores de r a una referencia de valor de l. El compilador genera el siguiente mensaje de error para este caso: la referencia de lvalue al tipo ‘int’ no se puede vincular a un temporal de tipo ‘int’.
A continuación, queremos crear una referencia rvalue rvárbitro(→//2). Para hacer esto, anteponemos el identificador con el doble Kaufmans Y y vinculamos la referencia al valor temporal 10. Debido al vínculo, este valor sigue siendo válido más allá del final de la declaración y es válido hasta el alcance de rvref se deja de nuevo. Por lo tanto, hemos utilizado una referencia rvalue para cambiar la vida útil de un objeto temporal.
Si ahora probamos cambiar el 10 al valor i, obtenemos nuevamente un mensaje de error: la referencia de valor r al tipo ‘int’ no puede enlazarse con el valor l de tipo ‘int’.
Por lo tanto, solo podemos asignar un valor temporal a una referencia de valor variable y ningún valor variable. Sin embargo, si posteriormente asignamos el valor 20 a rvref y luego generar el valor de la referencia rvalue rvreferencia a la consola, entonces salida 2 muestra que el cambio ha afectado directamente al objeto original en la memoria. Entonces podemos usar referencias de rvalue para hacer que los valores temporales estén disponibles permanentemente y cambiarlos.
Experimento 2
En el segundo experimento, queremos ver la capacidad del compilador para distinguir los valores L de los valores R y llamar a la variante de función correspondiente según el tipo de argumento pasado.
Listado 16 por lo tanto, contiene dos variantes de la función passValue() para valores L con & y valores R con &&. Dentro de las funciones, se envía una cadena correspondiente a la consola. En main() ahora llamamos al nombre de la función primero con el lvalue i y luego con un rvalue 5 como argumento (→//3). De salida 3 podemos ver que el compilador puede elegir la función correcta según el argumento. En la próxima publicación, veremos esto nuevamente en detalle en el contexto del constructor de movimiento y el operador de asignación de movimiento.
Finalmente, analicemos un ejemplo más. Ya hemos creado una referencia rvalue con rvref y lo usé para tareas. Ahora surge la pregunta a qué variante de passValue() se llama cuando pasamos rvref, es decir, una referencia Rvalue, como argumento (→//4).
En salida 4 podemos ver que, curiosamente, el compilador interpretó rv_ref no como un valor R, sino como un valor L. Esto muestra una conexión muy importante: las referencias de rvalue son básicamente lvalues: si adjuntamos un identificador a un valor temporal en la memoria y, por lo tanto, lo hacemos disponible en todo el alcance, entonces la referencia de rvalue se comporta de la misma manera que un lvalue. Y es por eso que solo tiene sentido aquí si el compilador llama a la variante Lvalue de la función.
Entonces, las referencias de Rvalue permiten crear un alias para valores temporales. El compilador puede saber cuándo se llama a una función si se pasó un valor l o un valor r. En la próxima publicación veremos cómo esto es posible gracias a la semántica de movimiento.
Desarrolle sus habilidades de C++.
C++ es un lenguaje de programación compilado de alto rendimiento. Los robots, los automóviles y el software integrado dependen de C++ para la velocidad de ejecución. Explore el C++ Developer Nanodegree para ampliar sus habilidades de ingeniería de software en el desarrollo de C++.