Cora Frazier sobre cómo escribir divertido – Harvard Gazette

preguntarse es una serie de preguntas aleatorias respondidas por expertos. La comediante Cora Frazier ’11, cuyo trabajo ha aparecido en Harvard Lampoon, The New Yorker, McSweeney’s, The New York Times y en «Saturday Night Live», lanzó recientemente la serie de podcasts «Creo que estás proyectando». Aquí, ella explica cómo se ríe.

Escribir humor es como poner a punto una nube. La inspiración y el deleite iniciales son vaporosos y difíciles de delinear o definir, mientras que el acto de ordenar chistes, párrafos y páginas es mecánico; un escritor puede orientar elementos en patrones específicos y conocidos para crear el mismo deleite.

Primero, el vapor. Todos se inspiran, pero no de la misma manera. Cuando se me ocurren ideas, a menudo me siento como el personaje de Emmeline Grangerford en “Huckleberry Finn”, que escribió elegías para personas y animales fallecidos, entre ellas, “I Shall Never Hear Thy Sweet Chirrup More Alas”. Tiendo a la melancolía, que puede volverse ostentosa y divertida incluso para mí. Así que mis ideas a menudo se originan en una profunda tristeza o frustración. Caigo tan bajo que apenas puedo moverme o pensar, como si estuviera acostado en un sofá desmayado, y empiezo a escuchar una voz susurrando en mi oído. Al principio lo ignoro. Pienso, “Shh. Estoy demasiado deprimido. Pero luego la voz sigue hablando y, finalmente, creo que lo que está diciendo puede ser divertido. Así que me levanto y escribo hasta que la voz se calla. No miro lo que he escrito durante días, semanas o meses.

Y luego me convierto en mecánico. En su nivel más fundamental, una broma es una trampa y un chiste. Más conceptualmente, una broma crea una expectativa y luego la socava. Jack Handey es siempre un buen ejemplo. Establece una expectativa de lo que vendrá después: “Puedo imaginarme un mundo sin guerra, un mundo sin odio”. Y luego subvierte esa expectativa: «Y puedo imaginarnos atacando ese mundo, porque nunca lo esperarían». Los chistes tienen todo tipo de longitudes y formatos, pero, fundamentalmente, se adhieren a este concepto. La risa viene de la sorpresa.

Para escribir una pieza de humor, que es una serie de chistes sobre un tema similar, un escritor necesita crear expectativas constantemente y socavarlas constantemente. Y una forma de hacerlo es combinar dos lenguajes inesperados. Por ejemplo, Colin Nissan tiene un artículo en McSweeney’s Internet Tendency llamado «It’s Decorative Gourd Season, Motherf*ckers». Sus dos idiomas no son especialmente complicados: está combinando el lenguaje de la decoración del hogar de temporada otoñal con blasfemias (quizás el lenguaje más intercultural y reconocible).

Otra forma de lograr esto es pensar en combinaciones inesperadas en la forma. Uno de los beneficios de la tecnología en constante cambio es que constantemente estamos creando y encontrando nuevas formas. Las “Reseñas de Navidad en Yelp” de David Sedaris serían irreconocibles para los primeros humoristas estadounidenses, pero su combinación del lenguaje de Yuletide con el lenguaje de la reseña de Yelp (“tiene demasiadas nueces y soy alérgico”) sería conceptualmente familiar, al igual que «Record Roundup» de Veronica Geng, que ofrece reseñas musicales de las cintas de Nixon.

Idealmente, los dos lenguajes inesperados se pueden combinar infinitamente para crear nuevos chistes. Pero, ¿cómo y en qué orden? Creo que la trama es un aspecto subestimado de la escritura humorística. La trama de comedia más clásica es la escalada a la erupción. Esencialmente, cada boceto sigue este formato: un personaje hace algo loco, el personaje hace algo más loco, el personaje hace algo aún más loco y ¡bum! se produce una erupción y termina el boceto. Para ejecutar esta trama en una obra de humor, un escritor ordena los chistes en orden creciente de desenfreno. Esto tiene sentido, si aceptamos que la risa es producto de la sorpresa; una vez que el lector conoce el juego de la combinación de idiomas, necesita algo incluso más inesperado que lo que ya han leído para seguir riendo.

Sin embargo, y esto es más una creencia personal, creo que incluso la trama de «escalada a erupción» puede ser esperada. Los lectores de comedia estarán familiarizados con ella. Entonces, cuando escribo humor, trato de pensar en un cambio potencial a la mitad o más de la pieza, una pista de cambio que finalmente no se cumple. Siempre vuelvo a la premisa original al final de la pieza, porque no creo que la comedia en prosa (o incluso una historia corta, para el caso) sea el lugar para un cambio radical de personajes. Y creo que hay algo gracioso en que un personaje reconozca el potencial de cambio, realmente lo vea y decida: “Nah. Voy a seguir haciendo lo que estoy haciendo”.

—Según lo dicho a Anna Lamb/Escritora del personal de Harvard

Anuncio de varios títulos y certificados nuevos, características de la plataforma de inteligencia artificial generativa y soluciones de contratación de Coursera para brindar un mejor servicio a la comunidad en todo el mundo

Por Jeff Maggioncalda, CEO de Coursera

Nuestra Conferencia anual de Coursera reúne a líderes de la educación superior, la industria y los gobiernos a nivel mundial para discutir tendencias críticas, colaboraciones de ecosistemas y avances tecnológicos que dan forma al futuro del aprendizaje y el trabajo. La conferencia de este año, en su 11ª edición, es particularmente significativa. La creciente demanda de trabajos remotos continúa transformando el mercado laboral global, y el asombroso aumento de la IA generativa crea nuevas posibilidades para el aprendizaje personalizado e interactivo. A medida que las empresas adopten la IA generativa para mejorar las ofertas y la productividad de los clientes, también creará una demanda sin precedentes de recapacitación: hasta el 49 % de los trabajadores tendrán la mitad o más de sus tareas expuestas a grandes modelos lingüísticos.

Hoy, nos complace anunciar varias ofertas de contenido nuevo, innovaciones en la plataforma impulsada por ChatGPT y experiencias de aprendizaje inmersivo ampliadas para servir mejor a nuestros estudiantes y educadores en todo el mundo. Además, estamos lanzando Coursera Hiring Solutions para ayudar a conectar a los estudiantes con trabajos digitales de nivel de entrada en todo el mundo.

Lanzamiento de 8 nuevos títulos, 3 Certificados Profesionales y un catálogo creciente de contenido generativo de IA:

  • Estamos entusiasmados de expandir nuestra cartera de títulos en línea relevantes para el trabajo con ocho nuevos programas en áreas de alta demanda, como informática, ciencia de datos y administración de empresas. Ofrecidas por universidades líderes como Illinois Tech, UC Boulder, Ball State University y SPJIMR, estas adiciones llevan nuestro catálogo a más de 50 títulos de licenciatura y maestría disponibles en la plataforma. Muchos de estos programas ofrecerán vías accesibles, incluidas admisiones basadas en el desempeño sin requisitos previos para atender a estudiantes con o sin antecedentes relevantes. Con precios por debajo de $20,000, todos los títulos nuevos ofrecen asequibilidad y accesibilidad excepcionales, especialmente adecuados para adultos que trabajan.
  • Para ayudar a los estudiantes a prepararse para los trabajos más solicitados, estamos lanzando dos Certificados profesionales de nivel básico de IBM en desarrollo front-end y gestión de proyectos de TI, diseñados específicamente para estudiantes sin un título o experiencia en la industria, y Spark AR Developer Certificado profesional avanzado de Meta para estudiantes intermedios o avanzados.
  • También estamos ampliando el aprendizaje inmersivo en la plataforma con varias experiencias de cursos de realidad virtual para los alumnos. Estos incluyen cursos de Duke, la Universidad de Pekín, la Universidad de Michigan y la Universidad de Washington que cubren una variedad de habilidades como hablar en público, liderazgo, fisiología humana, movilidad, aprendizaje de idiomas y capacitación para profesionales de la salud.
  • Para satisfacer la creciente demanda de habilidades de IA en la fuerza laboral, Coursera está aumentando su selección de cursos relacionados con la IA, incluido ChatGPT Teach-Out (Universidad de Michigan) e IA para una buena especialización (DeepLearning.AI).

Lee esto Blog para obtener más información sobre los nuevos títulos y contenidos, anunciados en la Conferencia de Coursera de 2023.

Marcando el comienzo de una nueva era de aprendizaje en línea personalizado e interactivo en Coursera

El aprendizaje en línea ha evolucionado de una experiencia pasiva de ver videos a una participación activa a través de proyectos colaborativos, cuestionarios y evaluaciones. Hoy, nos complace anunciar dos herramientas impulsadas por ChatGPT para hacer que el aprendizaje sea más interactivo y la enseñanza más efectiva en Coursera.

  • ENTRENADOR DEL CURSO – Los alumnos tendrán acceso a un entrenador virtual, impulsado por IA generativa, que puede responder preguntas y compartir comentarios personalizados. El entrenador podrá proporcionar recursos y resúmenes rápidos de conferencias en video, como un clip recomendado, para ayudar a los alumnos a comprender mejor un concepto específico. Con el tiempo, Coach también apoyará a los estudiantes con orientación profesional y preparación para entrevistas. Comenzaremos a implementar Coach para nuestra población de estudiantes en los próximos meses.
  • CONSTRUCCIÓN DE CURSOS ASISTIDA POR IA – Basándose en unas pocas indicaciones simples de un autor humano, la herramienta de creación de cursos utilizará IA generativa para generar automáticamente contenido del curso, como la estructura general del curso, descripciones, etiquetas, lecturas, tareas, glosarios y sugerencias del público relevante. contenido ya en Coursera que podría incluirse. Esta herramienta estará disponible a través de un programa piloto para seleccionar socios educadores a finales de este año.

También estamos implementando traducción impulsada por aprendizaje automático a escala para hacer que el aprendizaje en Coursera sea más accesible para nuestros estudiantes en todo el mundo. En los próximos meses, se traducirán del inglés al español, francés, alemán, árabe, portugués, tailandés e indonesio miles de lecturas de cursos, subtítulos de videos de conferencias, cuestionarios, evaluaciones, instrucciones de revisión por pares y mensajes de debate en más de 2000 cursos. A partir del primer trimestre de 2023, más de 35 millones de estudiantes registrados en Coursera se encuentran en países con estos siete idiomas como idioma oficial.

Lee esto Blog para obtener más información sobre las nuevas herramientas y características de la plataforma, anunciadas en la Conferencia de Coursera de 2023.

Lanzamiento de Coursera Hiring Solutions para conectar a los estudiantes con trabajos

La conectividad de banda ancha, el aprendizaje en línea y las oportunidades de trabajo remoto están desbloqueando nuevas formas para que las personas capacitadas participen en la economía global, independientemente de su ubicación o experiencia previa. Cada vez más, los empleadores están considerando la contratación basada en habilidades para abordar la escasez de talento y aumentar la diversidad en su lugar de trabajo. Sin embargo, verificar la habilidad de un candidato sigue siendo un desafío, especialmente para los puestos de nivel de entrada, cuando un principiante o un cambio de carrera puede carecer de un título universitario o experiencia laboral previa relevante.

Hoy, nos complace anunciar el lanzamiento de Coursera Hiring Solutions (Beta), nuestro servicio de contratación basado en habilidades que combina talento capacitado en la industria y listo para el trabajo para empresas que ocupan puestos digitales de nivel de entrada. Con las soluciones de contratación de Coursera:

  • Solicitantes de empleo pueden desarrollar las habilidades y credenciales que necesitan para ser considerados para trabajos digitales de nivel de entrada, y pueden usar su perfil de habilidades para mostrar su preparación laboral a los empleadores con credenciales, evaluaciones, proyectos y más.
  • Reclutadores puede usar el Panel de talentos para ver el talento de nivel de entrada precalificado en un solo lugar, con filtros para habilidades y credenciales para identificar candidatos que cumplan con sus requisitos únicos de abastecimiento. También pueden verificar el dominio de las habilidades de los candidatos a escala con evaluaciones alineadas con el trabajo.

Lanzamos la solución en India para estudiantes y un número selecto de empleadores, con planes de expandirnos a EE. UU. en los próximos meses.

Lee esto Blog para obtener más información sobre las soluciones de contratación de Coursera, anunciadas en la Conferencia de Coursera de 2023.

La pandemia ha impulsado la adopción del aprendizaje en línea y el trabajo remoto a una escala sin precedentes, creando nuevas oportunidades para el talento en todo el mundo. La IA generativa nos recuerda una vez más que el cambio implacable obligará a todos a aprender y adaptarse continuamente. Junto con nuestros socios educadores, estamos comprometidos a ayudar a los estudiantes y las instituciones a convertir el cambio y la disrupción en oportunidades más equitativas para todos.

Los niños de reproducción asistida crecen bien, pero puede ser mejor hablarles temprano sobre sus orígenes biológicos

El estudio, realizado por investigadores de la Universidad de Cambridge, es el primero en examinar los efectos a largo plazo de diferentes tipos de reproducción asistida por terceros en la crianza y el ajuste de los niños, así como el primero en investigar prospectivamente el efecto de la edad a la que los niños se les dijo que fueron concebidos por donación de óvulos, donación de esperma o subrogación.

Los resultados, publicados hoy en Developmental Psychology, sugieren que la ausencia de una conexión biológica entre hijos y padres en familias de reproducción asistida no interfiere en el desarrollo de relaciones positivas entre ellos ni en el ajuste psicológico en la edad adulta. Estos hallazgos son consistentes con evaluaciones previas a la edad de uno, dos, tres, siete, diez y 14 años.

Los hallazgos anulan las suposiciones previas ampliamente difundidas de que los niños nacidos por reproducción asistida por terceros están en desventaja en lo que respecta al bienestar y las relaciones familiares porque carecen de una conexión biológica con sus padres.

«A pesar de las preocupaciones de la gente, las familias con niños nacidos a través de reproducción asistida por terceros, ya sea un donante de óvulos, un donante de esperma o un sustituto, están bien hasta la edad adulta», dijo Susan Golombok, profesora emérita de Family Research y ex directora. del Centro de Investigación Familiar de la Universidad de Cambridge, quien dirigió el estudio.

Sin embargo, encontraron que las madres que comenzaron a contarles a sus hijos sobre sus orígenes biológicos en los años preescolares tenían relaciones más positivas con ellos según lo evaluado por una entrevista a los 20 años, y las madres mostraron niveles más bajos de ansiedad y depresión. La mayoría de los padres que lo habían revelado lo hicieron a los cuatro años y descubrieron que el niño se tomó bien la noticia. Esto sugiere que es ventajoso ser abierto con los niños acerca de sus orígenes cuando son pequeños.

Además, en la etapa final de este estudio de 20 años, las madres que habían revelado los orígenes de sus hijos a los siete años obtuvieron puntajes ligeramente más positivos en las medidas del cuestionario de calidad de las relaciones familiares, aceptación de los padres (sentimientos de la madre hacia el adulto joven) y comunicación familiar. Por ejemplo, solo el 7% de las madres que lo habían revelado a los 7 años reportaron problemas en las relaciones familiares, en comparación con el 22% de las que lo habían revelado después de los 7 años.

Los adultos jóvenes a los que se les había hablado de sus orígenes antes de los siete años obtuvieron puntuaciones ligeramente más positivas en las medidas del cuestionario de aceptación de los padres (percepción de los adultos jóvenes sobre los sentimientos de la madre hacia ellos), comunicación (hasta qué punto se sienten escuchados, saben lo que sucede en su familia y recibir respuestas honestas a las preguntas), y el bienestar psicológico. También eran menos propensos a reportar problemas en el cuestionario de relaciones familiares; mientras que el 50 % de los adultos jóvenes informados después de los 7 años reportaron tales problemas, esto fue cierto solo para el 12,5 % de los informados antes de los 7 años.

“Parece haber un efecto positivo de ser abierto con los niños cuando son jóvenes, antes de que vayan a la escuela, acerca de su concepción. Es algo que también han demostrado los estudios de familias adoptivas”, dijo Golmobok.

Investigadores de la Universidad de Cambridge siguieron a 65 familias del Reino Unido con niños nacidos por reproducción asistida (22 por subrogación, 17 por donación de óvulos y 26 por donación de esperma) desde la infancia hasta la adultez temprana (20 años). Compararon estas familias con 52 familias de concepción sin ayuda del Reino Unido durante el mismo período.

“Las familias de reproducción asistida estaban funcionando bien, pero donde vimos diferencias, estas fueron un poco más positivas para las familias que habían revelado”, dijo Golombok.

Reflexionando sobre sus sentimientos acerca de sus orígenes biológicos, los adultos jóvenes generalmente no se preocuparon. Como dijo un adulto joven nacido a través de la subrogación: «Realmente no me desconcierta, las personas nacen de diferentes maneras y si yo nací un poco diferente, está bien, lo entiendo».

Otro adulto joven nacido a través de la donación de esperma dijo: «Mi papá es mi papá, mi mamá es mi mamá, nunca he pensado realmente en cómo las cosas son diferentes, así que es difícil de decir, realmente no me importa».

Algunos adultos jóvenes adoptaron activamente el método de su concepción, ya que los hizo sentir especiales: “Creo que fue increíble, creo que todo es absolutamente increíble. Erm… no tengo nada negativo que decir al respecto en absoluto.”

Los investigadores encontraron que las madres que donaron óvulos reportaron relaciones familiares menos positivas que las madres que donaron esperma. Sugieren que esto podría deberse a las inseguridades de algunas madres sobre la ausencia de una conexión genética con su hijo. Esto no se reflejó en las percepciones de los adultos jóvenes sobre la calidad de las relaciones familiares.

El equipo también encontró que los adultos jóvenes concebidos por donación de esperma reportaron una comunicación familiar más pobre que aquellos concebidos por donación de óvulos. Esto podría explicarse por el mayor secretismo en torno a la donación de esperma que a la donación de óvulos, a veces impulsado por una mayor reticencia de los padres que de las madres a revelar a sus hijos que no son sus padres genéticos, y una mayor reticencia a hablar de ello una vez que lo han revelado.

De hecho, los investigadores encontraron que solo el 42 % de los padres donantes de esperma lo revelaron antes de los 20 años, en comparación con el 88 % de los padres donantes de óvulos y el 100 % de los padres sustitutos.

“Hoy en día hay tantas más familias creadas por reproducción asistida que parece bastante común”, dijo Golombok. “Pero hace veinte años, cuando comenzamos este estudio, las actitudes eran muy diferentes. Se pensaba que tener un vínculo genético era muy importante y sin uno, las relaciones no funcionarían bien.

“Lo que significa esta investigación es que tener hijos de maneras diferentes o nuevas en realidad no interfiere con el funcionamiento de las familias. Realmente querer tener hijos parece triunfar sobre todo, eso es lo que realmente importa”.

Esta investigación fue financiada por un premio Wellcome Trust Collaborative Award.

Golombok, S., Jones, C., Hall, P., Foley, S., Imrie, S. y Jadva, V. Un estudio longitudinal de familias formadas mediante reproducción asistida por terceros: relaciones madre-hijo y ajuste infantil desde la infancia hasta la edad adulta. Psicología del desarrollo DOI: 10.1037/dev0001526

El Centro para la Investigación de la Familia colabora con el Museo Fitzwilliam en una nueva exposición, Familias reales: historias de cambio (octubre – 7 de enero de 2024), comisariada por el profesor Golombok. La exposición explorará las complejidades de las familias y las relaciones familiares a través de los ojos de artistas como Paula Rego, Chantal Joffe, JJ Levine, Lucian Freud y Tracey Emin.

La profesora Susan Golombok es autora de We Are Family: What Really Matters for Parents and Children (Scribe), que describe la investigación de nuevas formas familiares desde la década de 1970 hasta la actualidad.

funciones rápidas | audacia

En este artículo, repasaremos qué es una función de Swift, cómo escribir una función de Swift, cómo insertar valores en las funciones de Swift y cómo las funciones de Swift pueden devolver valores. ¡Empecemos!

¿Qué es una función?

EN función es una pieza de código que hace algo. Lo que hace su función, depende de usted.

Por ejemplo:

  • Enviar un formulario
  • Abrir una página de cuenta
  • Calcular la ruta más rápida entre dos puntos

En el nivel más básico, esto es lo que hace una función. Las funciones son muy útiles porque son fragmentos de código compartimentados a los que se puede llamar para realizar una tarea una y otra vez.

¿Cómo escribo una función Swift? (Declarando una función)

En Swift, usas la palabra clave función para declarar una función. Le sigue el nombre de la función con paréntesis abierto y cerrado () con el declaración de función entre llaves {}.

Estructura de la función Swift:

func functionName(){
    functionStatement
}

Vamos a crear su primera función Swift. Comienza con la palabra función seguido de tu nombre de la función con paréntesis abierto y cerrado:

A continuación, agreguemos su declaración de función dentro de llaves. Usemos la declaración de impresión para mostrar en la consola:

//writing my first function
func myFirstFunction(){
    print("This is my first function! Yay!")
}

En este ejemplo, «myFirstFunction» es el nombre de la función, mientras que el declaración de función imprime una cadena de texto en la consola. Si fuiste capaz de seguir hasta aquí, ¡felicidades! Acabas de declarar tu primera función de Swift.

Llamar a una función de Swift

Ahora que hemos declarado nuestra función Swift, debemos llamarla para usarla. En Swift, llamas a una función escribiendo el nombre de la función seguido de paréntesis.

Intentemos llamar a nuestra función «myFirstFunction»:

//Calling my function
myFirstFunction()

Producción:

This is my first function! Yay!

Si ejecuta esto en Swift Playgrounds, verá el mismo resultado:

Si desea probar esto por su cuenta sin instalar Swift Playgrounds, aquí hay una manera de hacerlo en línea. https://replit.com/languages/swift

Poner valores en funciones de Swift (parámetros)

Profundicemos un poco más. Eche un vistazo a los paréntesis: en realidad puede insertar un parámetros con un amable para que su salida cambie según el valor que use. (Nota: siempre debe declarar qué tipo devolverá, ya que el lenguaje Swift es un lenguaje fuertemente tipado).

Volviendo a nuestra estructura de funciones:

//Swift function structure
func functionName(parameter: type){
    functionStatement
}

Vamos a crear una función que salude con el nombre de tu amigo según su nombre:

func greetFriend(friendName: String){
    print("Ahoy there, " + friendName)
}

Llamemos a nuestra función:

greetFriend(friendName: "Michael")

producción:

¿Y si, en lugar de Michael, queremos saludar a Melissa? ¡Los parámetros pueden hacer que eso suceda!

greetFriend(friendName: "Melissa")

producción:

Las funciones Swift pueden devolver valores

Vayamos a otra capa más profunda. ¿Qué pasaría si, en lugar de solo ingresar valores, quisiera obtener un valor de retorno?

Volvamos a la estructura de nuestra función:

//Swift function structure
func functionName(parameter: type) -> type {
    functionStatement
    return returnStatement 
}

Al agregar una devolución, debemos declarar qué tipo de devolución es dentro de nuestra declaración de función. Además, necesitamos incluir la palabra devolver al final de nuestra declaración de función y decir lo que queremos devolver.

Vamos a crear una función que nos diga cuánto dinero obtendremos si trabajamos x cantidad de horas a x tarifa por hora:

func calculatePay(hourlyRate: Int, hoursWorked: Int) -> Int {
    var totalPay = hourlyRate * hoursWorked
    return totalPay
}

Llamemos a nuestra función:

calculatePay(hourlyRate: 40; hoursWorked: 20)

producción:

Hmm, ¿por qué no veo nada en la consola? Devolver no significa necesariamente imprimir. Para imprimir en la consola, necesitamos encapsular el retorno dentro de una función de impresión:

print("Total pay: ",calculatePay(hourlyRate:40, hoursWorked:20)

producción:

¡Y ahí lo tienes! Una introducción a las funciones de Swift. En una publicación de blog futura, profundizaremos en una discusión más detallada de las funciones con los cierres de Swift. ¡Feliz codificación!

¿Quieres saber más sobre Swift? Explore el nanogrado para convertirse en desarrollador de iOS de Udacity.

Tomando una lección de adaptación evolutiva de pulpo, calamar – Harvard Gazette

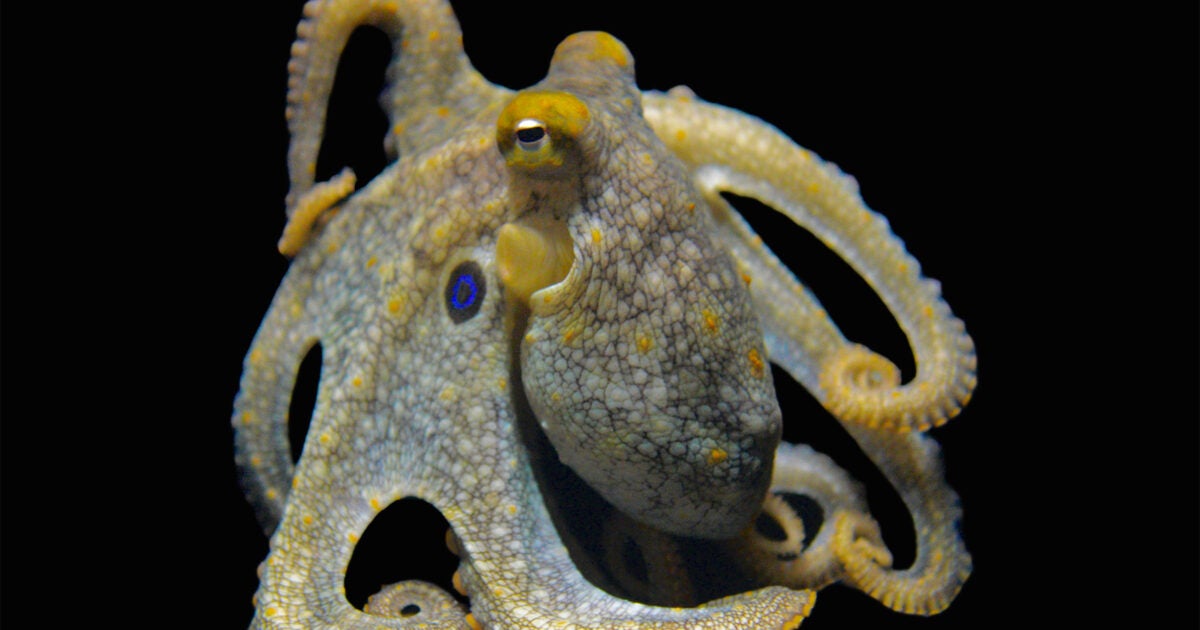
A diferencia de sus primos pulpos, los calamares son depredadores de emboscada que atacan y capturan presas desprevenidas con sus ocho brazos y dos largos tentáculos. En lugar de usar sus brazos para sondear las superficies, agarran a la presa y la enrollan para comer.

“En el segundo artículo, encontramos que los receptores químicos del calamar son más análogos a nuestro sentido del gusto”, dijo Bellono. El equipo descubrió que los receptores de calamar se han adaptado para detectar moléculas amargas. Si un calamar siente amargura, puede interpretarla como tóxica o indeseable y liberará a su presa. Nuevamente, el equipo encontró que la principal diferencia entre el receptor del neurotransmisor humano y el receptor del calamar estaba en el bolsillo de unión.

“En este caso, había menos receptores que en el pulpo, y se parecían más al bolsillo de unión de neurotransmisores que puede unir más moléculas hidrofílicas”, dijo Bellono. “Vemos esta diferencia entre el pulpo y el calamar como un reflejo de una línea de tiempo evolutiva y una adaptación, donde vemos la transición de la neurotransmisión en los receptores de acetilcolina al sabor amargo soluble en el calamar, a la innovación más reciente de la detección de moléculas insolubles al tacto. en pulpo.”

En 2020, el equipo de Bellono informó por primera vez que los pulpos usan receptores quimiotáctiles en sus brazos para buscar y explorar su entorno. Juntos, estos dos nuevos artículos proporcionan una base para comprender cómo las sutiles adaptaciones estructurales, como las de los receptores de cefalópodos, pueden impulsar nuevos comportamientos adecuados al contexto ecológico específico de un animal.

“Los cefalópodos son excelentes modelos para estudiar la evolución. Estos estudios presentan un ejemplo agradable e inesperado de cómo explotar estas criaturas para estudiar la innovación biológica desde los niveles atómicos hasta los de los organismos”, dijo Bellono.

Web scraping con Python: Solicitudes

El raspado web es el proceso de extracción de datos de sitios web. Puede ser tan simple como copiar y pegar manualmente desde una página web. Sin embargo, más comúnmente se refiere al uso de scripts o bots para extraer los datos automáticamente.

Peticiones

El paquete Requests es uno de los paquetes más descargados para Python. Tiene un promedio de alrededor de 30 millones de descargas por semana (Solicitudes, 2023). Las solicitudes brindan la capacidad de consultar el código HTML de una página web a través de Python. Si bien su uso más común es como una herramienta API, también es excelente para extraer información de HTML sin tener que depender de un navegador.

Debido a su popularidad, las solicitudes vienen incluidas en muchas distribuciones populares de Python, incluida Anaconda. Si su instalación no tiene solicitudes, simplemente ejecute una instalación de Pip desde el símbolo del sistema o terminal.

Un tutorial completo sobre el paquete de solicitudes podría ocupar un curso de Udacity. Este artículo de blog se centrará en la interacción con los códigos de estado HTML y HTTP para proporcionar una idea de cómo responde una página web. Este artículo cubrirá la .get() método para llamar a una URL. A partir de ahí, aprenderemos a utilizar métodos adicionales como status_code, text, findy content.

solicitudes.get()

Té .get() El método de las solicitudes funciona pasando una URL. Esto devuelve el código html que conforma la URL en cuestión. En este ejemplo, vamos a ver el sitio web principal de Udacity. Tenga en cuenta la salida: <Response [200]>. Este es el código de estado HTML.

Código de estado

Status_code se puede utilizar para devolver los códigos de estado HTTP de un sitio web. Esto puede proporcionar información vital sobre cómo está respondiendo un sitio web.

Los códigos de estado HTTP funcionan de la siguiente manera:

  • 100’s la solicitud fue recibida
  • 200’s la solicitud se actuó con éxito
  • 300’s la solicitud requería una redirección
  • error del cliente 400
  • error del servidor 500

Básicamente, al monitorear la respuesta de un sitio web, un código de respuesta que comienza con 1, 2 o 3 significa que la página funciona bien. 4 o 5 muestran que el sitio web no responde. Puede usar status_code para obtener el código de estado directo que puede pasar a una variable.

Texto Descripción generado automáticamente

Otra opción es .okque devolverá True para cualquier código de estado por debajo de 400

Texto Descripción generado automáticamente

Cualquiera status_code oro ok son excelentes para crear un script que monitoree la capacidad de respuesta del sitio web. Si está monitoreando un conjunto de sitios web, este script puede alertarlo sobre problemas antes de que los correos electrónicos de quejas comiencen a llegar.

Se acabó el tiempo

Hablando de capacidad de respuesta. A veces, los problemas con una página web pueden causar una .get() solicitud para colgar. Esto puede durar unos segundos, unas horas o hasta que se emita un comando de interrupción. Una forma de evitar esto es simplemente agregar un argumento de tiempo de espera. En el siguiente ejemplo, la llamada expirará después de 3 segundos si no hay respuesta.

Texto Descripción generado automáticamente

.texto

Té .text método devuelve el código HTML detrás del sitio web.

El HTML de un sitio web a veces puede ser un poco abrumador, por lo que agregar una segmentación (como se muestra a continuación) al r.text El comando devuelve solo los primeros 150 caracteres.

Texto Descripción generado automáticamente

Desafortunadamente, el .text El método devuelve texto sin procesar y no proporciona ningún análisis de HTML. Para eso, necesitará usar un paquete de análisis como Hermosa sopa. .text tiene un .find método que permite buscar el texto sin procesar del HTML. En el siguiente ejemplo, find devuelve la posición inicial del carácter de la palabra Udacity en el código HTML. Entonces, mirando el ejemplo de la segmentación anterior, puede ver que la U en Udacity es el 122n / A carácter en esa cadena de texto.

Texto Descripción generado automáticamente

Té r.content al principio se ve como r.text salida, pero mientras r.text es Unicode, r.content es una salida de bytes, lo que significa que puede manejar cosas más allá del texto, como imágenes. r.content también se puede utilizar para guardar el código HTML en un formato de archivo.

Este es un gran método para monitorear los cambios en un sitio web o crear instantáneas de cómo se estaba desempeñando un sitio web en un momento específico.

Interfaz gráfica de usuario, aplicación, tabla, Excel Descripción generada automáticamente

Conclusión

Si bien las solicitudes de paquetes de Python en realidad están más orientadas a trabajar con API, pueden ser una herramienta útil para el rastreo web básico y el monitoreo de sitios web. Agregar herramientas de análisis como Beautifulsoup puede mejorar enormemente el trabajo con HTML en Python. Sin embargo, a veces una búsqueda de texto sin formato o poder almacenar el código HTML como archivo es realmente todo lo que se necesita.

¿Está interesado en ampliar sus habilidades con Python? Udacity ofrece una variedad de cursos de Python para cualquier nivel de habilidad. Recién comenzando, pruebe nuestra Introducción a la programación Nanodegree y aprenda los conceptos básicos de codificación. Ya tiene una base de codificación, pruebe nuestro programa de Nanogrado intermedio de Python para aprender temas y habilidades de Python más avanzados.

Nuevos hallazgos que mapean el crecimiento cósmico del universo respaldan la teoría de la gravedad de Einstein

Los hallazgos, de la colaboración del Telescopio de Cosmología de Atacama que involucra a investigadores de la Universidad de Cambridge, brindan un mayor apoyo a la teoría de la relatividad general de Einstein, que ha sido la base del modelo estándar de cosmología durante más de un siglo. Los resultados ofrecen nuevos métodos para desmitificar la materia oscura, la masa invisible que se cree que representa el 85% de la materia del universo.

Durante milenios, los humanos han estado fascinados por los misterios del cosmos. Desde civilizaciones antiguas como los babilonios, griegos y egipcios hasta los astrónomos modernos, el encanto del cielo estrellado ha inspirado innumerables búsquedas para desentrañar los secretos del universo.

Y aunque los modelos que explican el cosmos han existido durante siglos, el campo de la cosmología, donde los científicos utilizan métodos cuantitativos para comprender la evolución y la estructura del universo, es relativamente nuevo: se formó a principios del siglo XX con el desarrollo de Albert Einstein. teoría de la relatividad general.

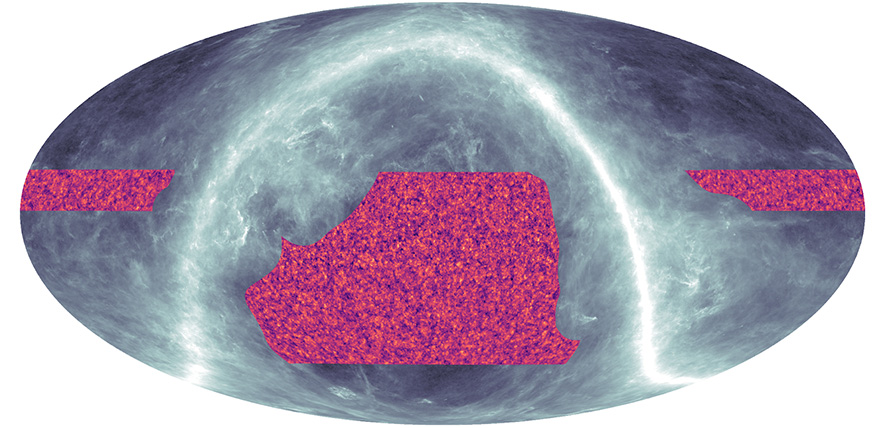
Ahora, un conjunto de documentos presentados a la Revista de cosmología y física de astropartículas por investigadores de la colaboración del Telescopio de Cosmología de Atacama (ACT) ha producido una nueva imagen que revela el mapa más detallado de la materia distribuida en una cuarta parte de todo el cielo, llegando a las profundidades del cosmos. Confirma la teoría de Einstein sobre cómo las estructuras masivas crecen y desvían la luz, con una prueba que abarca toda la edad del universo.

«Hemos mapeado la materia oscura invisible en el cielo a las distancias más grandes, y vemos claramente las características de este mundo invisible que tienen cientos de millones de años luz de diámetro», dijo el coautor, el profesor Blake Sherwin, del Departamento de Matemáticas Aplicadas y de Cambridge. Física Teórica, donde lidera un grupo de investigadores de ACT. «Parece tal como predicen nuestras teorías».

Aunque la materia oscura constituye una gran parte del universo y dio forma a su evolución, sigue siendo difícil de detectar porque no interactúa con la luz u otras formas de radiación electromagnética. Hasta donde sabemos, la materia oscura solo interactúa con la gravedad.

Para rastrearlo, los más de 160 colaboradores que han construido y recopilado datos del Telescopio de Cosmología de Atacama de la Fundación Nacional de Ciencias en los altos Andes chilenos observan la luz que emana después del amanecer de la formación del universo, el Big Bang, cuando el universo tenía solo 380.000 años. años. Los cosmólogos a menudo se refieren a esta luz difusa que llena todo nuestro universo como la «imagen infantil del universo», pero formalmente se conoce como la radiación cósmica de fondo de microondas (CMB).

El equipo rastrea cómo la atracción gravitatoria de estructuras grandes y pesadas, incluida la materia oscura, deforma el CMB en su viaje de 14 mil millones de años hacia nosotros, como una lupa que desvía la luz cuando pasa a través de su lente.

“Hemos hecho un nuevo mapa de masas utilizando las distorsiones de la luz que quedaron del Big Bang”, dijo Mathew Madhavacheril de la Universidad de Pensilvania, autor principal de uno de los artículos. «Sorprendentemente, proporciona mediciones que muestran que tanto la ‘grumosidad’ del universo como la velocidad a la que crece después de 14 000 millones de años de evolución son justo lo que cabría esperar de nuestro modelo estándar de cosmología basado en la teoría de Einstein. de la gravedad.”

“Nuestros resultados también brindan nuevos conocimientos sobre un debate en curso que algunos han llamado ‘La crisis de la cosmología’”, dijo Sherwin. Esta crisis se deriva de mediciones recientes que utilizan una luz de fondo diferente, una emitida por estrellas en galaxias en lugar de la CMB. Estos han producido resultados que sugieren que la materia oscura no era lo suficientemente grumosa según el modelo estándar de cosmología y generó preocupaciones de que el modelo podría romperse. Sin embargo, los últimos resultados del equipo de ACT pudieron evaluar con precisión que los grandes bultos que se ven en esta imagen tienen exactamente el tamaño correcto.

“Cuando los vi por primera vez, nuestras mediciones coincidían tan bien con la teoría subyacente que me tomó un momento procesar los resultados”, dijo el candidato a doctorado de Cambridge, Frank Qu, autor principal de uno de los nuevos artículos. “Pero todavía no sabemos qué es la materia oscura, por lo que será interesante ver cómo se resolverá esta posible discrepancia entre diferentes mediciones”.

“Los datos de la lente CMB compiten con estudios más convencionales de la luz visible de las galaxias en su capacidad para rastrear la suma de lo que hay”, dijo Suzanne Staggs de la Universidad de Princeton, directora de ACT. “Juntos, la lente CMB y los mejores estudios ópticos están aclarando la evolución de toda la masa del universo”.

“Cuando propusimos este experimento en 2003, esta medición ni siquiera estaba en nuestra agenda; no teníamos idea del alcance total de la información que podía extraerse de nuestro telescopio”, dijo Mark Devlin, de la Universidad de Pensilvania, Director Adjunto de ACT. «Se lo debemos a la inteligencia de los teóricos, a las muchas personas que construyeron nuevos instrumentos para hacer que nuestro telescopio sea más sensible y a las nuevas técnicas de análisis que ideó nuestro equipo».

Dado que ACT fue desmantelado a fines de 2022, se espera que se presenten más documentos que destacan algunos de los otros resultados finales el próximo año. Las observaciones continuarán en el sitio con el Observatorio Simons, incluido un nuevo telescopio que comenzará a funcionar en 2024 y que puede mapear el cielo casi diez veces más rápido.

Los artículos preimpresos destacados en este comunicado están disponibles en act.princeton.edu y aparecerán en arXiv.org de acceso abierto. Han sido enviados al Journal of Cosmology and Astroparticle Physics.

Este trabajo fue apoyado por la Fundación Nacional de Ciencias de EE. UU., la Universidad de Princeton, la Universidad de Pensilvania y un premio de la Fundación Canadiense para la Innovación. Los miembros del equipo de la Universidad de Cambridge recibieron el apoyo del Consejo Europeo de Investigación.

Crear un vector en R

Como todos los lenguajes de programación, R te permite crear variables. Aquí hay un ejemplo de cómo definir una variable en R:

diameter_of_pizza <- 16

Esta línea, que define una variable llamada diameter_of_pizza, podría ser útil si está escribiendo código para una pizzería para almacenar información sobre pedidos. Tenga en cuenta que la variable diameter_of_pizza solo puede ser igual a un número a la vez, porque es algo llamado escalar (una variable de un solo número). En este momento, es igual a 16. Más tarde, si su restaurante recibe un pedido de una pizza de 12 pulgadas, puede cambiar su valor fácilmente:

diameter_of_pizza <- 12

Cuando su restaurante recibe más de un pedido a la vez, querrá realizar un seguimiento de todos los pedidos a la vez. Es por eso que R permite crear vectores, que son variables que pueden contener matrices de diferentes valores. Por ejemplo, suponga que su restaurante recibe pedidos de 3 pizzas diferentes al mismo tiempo. Puede almacenar todos los diámetros de pizza en una variable vectorial muy fácilmente:

diameter_of_pizza <- c(8,16,20)

Aquí, usamos el c() función para crear un vector. La «c» es la abreviatura de «combinar», porque nos permite combinar varios valores y almacenarlos en una variable vectorial. Puede imprimir esta nueva variable vectorial de la siguiente manera:

print(diameter_of_pizza)

Cuando ejecute esta línea de código, verá el siguiente resultado:

[1]  8 16 20

Puede ver que R ha impreso 3 números en lugar de solo uno, ya que diameter_of_pizza es una variable vectorial, que contiene una matriz de valores únicos. Felicitaciones, ¡ha creado un vector en R!

Después de crear un vector, podemos modificar su contenido. Por ejemplo, si queremos cambiar el tercer pedido de pizza de un diámetro de 20 pulgadas a un diámetro de 21 pulgadas, podemos redefinir el valor del tercer elemento del vector de la siguiente manera:

print(diameter_of_pizza)

Podemos ver que solo el tercer elemento ha cambiado:

[1]  8 16 21

Los vectores son útiles porque podemos hacer operaciones en vectores completos a la vez, ahorrando tiempo y espacio. Por ejemplo, si queremos agregar seis pulgadas a cada pedido de pizza en nuestro vector, podemos hacerlo de la siguiente manera:

diameter_of_pizza <- diameter_of_pizza + 6

Cuando imprimes el vector usando print(diameter_of_pizza)verá que una línea de código ha agregado 6 pulgadas a cada elemento del vector:

[1]  14 20 27

Hay otras formas de crear vectores. Un atajo simple que puede usar son los dos puntos «:», que puede usar de la siguiente manera:

new_vector <- 1:10

Esta línea de código crea un vector de todos los números enteros entre 1 y 10. Puede ejecutar print(new_vector) para ver la salida:

[1]  1  2  3  4  5  6  7  8  9 10

También puede crear vectores usando el vector() dominio. Puede usar este método si tiene la intención de definir cada elemento del vector, uno a la vez:

y <- vector(length=2)

y[1] <- 3

y[2] <- 7

Aquí, definimos un vector llamado y con longitud 2, y luego definimos sus dos elementos como 3 y 7, respectivamente. cuando corres print(y)puede ver que hemos definido con éxito ambos elementos del vector:

[1] 3 7

Los vectores pueden contener otros tipos de datos además de números. Por ejemplo, también podemos definir un vector de cadenas:

string_vector<-c('Call','me','Ishmael')

Incluso puedes crear un vector de vectores:

vector_of_vectors<-c(c(1,2,3),c(4,5,6),c(7,8,9))

Sin embargo, cuando crea un vector de vectores, R automáticamente hace lo que se llama «aplanar», o en otras palabras, combina todos los elementos de cada vector en un solo vector. Puedes ver el vector ejecutando print(vector_of_vectors)que le dará el siguiente resultado:

[1] 1 2 3 4 5 6 7 8 9

¿Interesado en aprender más sobre R? Realice el curso Programación para ciencia de datos con R de Udacity y aprenda los fundamentos de R, incluidas estructuras de datos, variables, bucles, funciones y más.

Harvard fija fecha para inauguración de Claudine Gay – Harvard Gazette

Los actos de inauguración de Claudine Gay, la trigésima presidenta de Harvard, se llevarán a cabo el 29 de septiembre en el Teatro Tricentenary. Todos los miembros de la comunidad de Harvard están invitados a asistir a la ceremonia de la tarde. Más detalles estarán disponibles a medida que avance la planificación.

* * *

Conoce al próximo presidente de Harvard

Un líder experimentado con un compromiso fundamental con la libre consulta, un profundo aprecio por las diversas voces y una dedicación para crear oportunidades para los demás.

Claudine Gay dirigirá la institución que la inspiró desde el principio, con una creencia fundamental en las posibilidades infinitas de Harvard.

En el campus y más allá, el surgimiento de un «líder natural» fue motivo de celebración. Tanto los profesores como los estudiantes y el personal recibieron la elección de Gay como el próximo líder de Harvard con enfática alegría y elogios.

Los cinco principales blogs de Udacity que podrías haberte perdido en el primer trimestre de 2023

Siempre estamos creando blogs para involucrar a nuestros lectores en nuestras becas, eventos y esfuerzos de transformación de talentos. Estos son los 5 blogs principales que quizás te hayas perdido del primer trimestre de 2023.

La historia de Betty: cómo Udacity y AWS la ayudaron a alcanzar sus objetivos

Hacer un cambio de carrera es difícil, pero con la ayuda de la beca de aprendizaje automático e inteligencia artificial de Amazon Web Services, Betty ha podido hacer precisamente eso. ¡Mira el video a continuación para descubrir cómo Betty pudo aprovechar esta increíble oportunidad y alcanzar sus metas!

Por qué aprender a programar en 2023

La codificación hace posible acceder e interactuar con sitios web. Como éste. Diferentes tipos de código le dicen a una computadora qué acciones tomar. Escribir el código es como escribir instrucciones. Como codificador, puede crear sitios web y aplicaciones, procesar datos y completar muchas otras tareas útiles y lucrativas.

Los trabajos tecnológicos globales han crecido exponencialmente durante la última década. Y no hay final a la vista. Una de las mejores cosas de estos roles es que a menudo no requieren un título en informática.

Consejos de preparación para entrevistas técnicas

¿Se está preparando para una entrevista técnica y se siente abrumado por toda la información que hay? Ya sea que busque trabajo por primera vez o sea un profesional experimentado, los consejos de este artículo lo ayudarán a tener éxito en su entrevista.

Expectativas de salario de ingeniero de datos para 2023

Los ingenieros de datos, que no deben confundirse con los científicos de datos, son ingenieros que trabajan en la construcción y el mantenimiento de canalizaciones que recopilan datos para su análisis.

La Oficina de Estadísticas Laborales pronostica un aumento del 22 % en el crecimiento del empleo entre 2020 y 2030 dentro del campo de los datos, con un crecimiento mucho mayor que el promedio de otras ocupaciones.

Anuncio de nuestro nuevo chatbot de IA: guía de aprendizaje a pedido hecha

Estamos muy emocionados de anunciar el lanzamiento del nuevo chatbot de IA de Udacity, ¡ahora disponible en versión beta! Está impulsado por OpenAI y diseñado para mejorar su experiencia de aprendizaje.

Entendemos los desafíos que enfrentan los estudiantes cuando se trata de estudiar y completar proyectos del mundo real en línea. Un desafío común es la falta de apoyo y orientación personalizados cuando los alumnos más lo necesitan: en el flujo de aprendizaje y trabajando en soluciones a problemas difíciles.

Descubra más publicaciones de blog

El blog de Udacity tiene muchos artículos excelentes para obtener más información sobre lo último en tecnología y talento. Esperamos que haya disfrutado de estos blogs y que pueda descubrir más en nuestra página de inicio.

Al menos el 80% de los sitios terrestres más importantes del mundo para la biodiversidad contienen actualmente desarrollos humanos

Un estudio ha encontrado que la infraestructura en todo el mundo está muy extendida en sitios que han sido identificados como importantes internacionalmente para la biodiversidad, y es probable que aumente su prevalencia.

Esta es la primera evaluación de la presencia de infraestructura en Áreas Clave para la Biodiversidad (KBA): una red global de miles de sitios reconocidos internacionalmente como las áreas más críticas del mundo para la vida silvestre.

La infraestructura es uno de los mayores impulsores de las amenazas a la biodiversidad según la Unión Internacional para la Conservación de la Naturaleza. Puede causar la destrucción y fragmentación del hábitat natural, la contaminación, el aumento de la perturbación o la caza por parte de los humanos, la propagación de especies invasoras, la mortalidad directa y puede tener impactos más amplios más allá del sitio de desarrollo.

Ahora, investigadores de BirdLife International, WWF y RSPB, en asociación con la Universidad de Cambridge, han realizado una evaluación de la infraestructura en las ACB y han descubierto que está muy extendida y es probable que aumente. Los resultados se publican hoy en Conservación Biológica.

“Es preocupante que existan desarrollos humanos en la gran mayoría de los sitios que se han identificado como críticos para la naturaleza”, dijo Ash Simkins, estudiante de doctorado en zoología de la Universidad de Cambridge que dirigió el estudio.

Las KBA son sitios que contribuyen significativamente a la persistencia global de la biodiversidad. Por ejemplo, pueden contener especies que están en alto riesgo de extinción o son el hogar de especies o ecosistemas que se encuentran en un área pequeña en todo el mundo.

Los investigadores evaluaron 15 150 KBA en tierra y descubrieron que el 80 % contenía infraestructura. Se produjeron múltiples combinaciones de tipos de infraestructura en las ACB, siendo las más comunes las carreteras (75 %), las líneas eléctricas (37 %) y las áreas urbanas (37 %).

Descubrieron que los posibles desarrollos de infraestructura futuros planificados podrían conducir a 2201 KBA adicionales que contienen minas (de 754 a 2955; aumento del 292 %), 1508 KBA adicionales que contienen infraestructura de petróleo y gas (de 2081 a 3589; aumento del 72 %) y una 1.372 ACBs que contienen centrales (de 233 a 1.605; incremento del 589%).

Los mapas de las KBA se cruzaron con conjuntos de datos espaciales de diferentes tipos de infraestructura que los investigadores clasificaron como transporte, represas y embalses, extractivos (relacionados con los recursos naturales), energía (líneas eléctricas y centrales eléctricas) y áreas urbanas.

La energía y las industrias extractivas fueron las únicas categorías para las que se dispuso de algunos datos globales sobre posibles desarrollos futuros planificados.

“Reconocemos que la infraestructura es esencial para el desarrollo humano, pero se trata de construir de manera inteligente. Idealmente, esto significa evitar o minimizar la infraestructura en los lugares más importantes para la biodiversidad. Si la infraestructura debe estar allí, entonces debe diseñarse para causar el menor daño posible, y los impactos deben compensarse con creces en otros lugares”, dijo Simkins.

Los investigadores encontraron que los países de América del Sur (por ejemplo, el 82 % de las KBA en Brasil), África subsahariana, central y meridional y partes del sudeste asiático se encuentran entre las áreas con la mayor proporción de reclamos extractivos, concesiones o actividades planificadas. desarrollo en sus redes KBA. Todas las KBA identificadas hasta la fecha en Bangladesh, Kuwait, la República del Congo y Serbia tienen posibles reclamos extractivos, concesiones o desarrollo planificado.

“También es preocupante ver que en el futuro se planea construir una extensa infraestructura relacionada con la minería y el petróleo y el gas en muchos de los sitios más importantes del mundo para la biodiversidad”, dijo Simkins.

Parte de la tecnología para hacer frente a la crisis climática, como los paneles solares y las turbinas eólicas, también depende de la minería de metales preciosos. “Necesitamos soluciones inteligentes para la crisis climática mientras evitamos o minimizamos los impactos negativos en la biodiversidad”, dijo Simkins.

“En las reuniones COP15 de biodiversidad de la ONU en Montreal el año pasado, los gobiernos se comprometieron a detener las extinciones inducidas por el hombre”, dijo el coautor Dr. Stuart Butchart, científico jefe de BirdLife International e investigador honorario en el Departamento de Zoología de Cambridge. “La destrucción o degradación generalizada de los hábitats naturales dentro de las KBA podría conducir a extinciones masivas, por lo que la infraestructura existente en las KBA debe gestionarse para minimizar los impactos, y debe evitarse un mayor desarrollo en estos sitios en la medida de lo posible”.

“La infraestructura sustenta nuestras sociedades, entregando el agua que bebemos, los caminos por los que viajamos y la electricidad que impulsa los medios de vida”, dijo Wendy Elliott, líder adjunta de Vida Silvestre en WWF. “Este estudio ilustra la importancia crucial de garantizar el desarrollo de una infraestructura inteligente que proporcione valor social y económico para todos, al tiempo que garantiza resultados positivos para la naturaleza. Hacer que esto suceda será el desafío de nuestro tiempo, pero con la planificación, el diseño y el compromiso correctos, está dentro de los límites de la posibilidad”.

Los investigadores dicen que la infraestructura dentro de una KBA varía en el grado en que puede generar una pérdida de biodiversidad. Se requiere más investigación para averiguar hasta qué punto la infraestructura en una KBA en particular afecta la vida silvestre dentro del sitio y qué medidas se necesitan para mitigar esto.

Referencia: AT Simkins et al, Una evaluación global de la prevalencia de infraestructura actual y futura potencial en Áreas Clave para la BiodiversidadConservación Biológica, DOI: 10.1016/j.biocon.2023.109953