Wellcome otorga a Cambridge £18 millones por dos Discovery Research Platforms

Las Discovery Research Platforms (DRP) serán el hogar de entornos de investigación transformadores que empoderan a los investigadores para superar barreras específicas que frenan el progreso en sus campos de investigación. Su objetivo es acelerar la investigación en beneficio de la comunidad de investigación mundial en general, con investigadores y equipos que desarrollan nuevas herramientas, conocimientos y capacidades para ayudar a desbloquear nuevos hallazgos sobre la vida, la salud y el bienestar.

Michael Dunn, director de Discovery Research en Wellcome, dijo: “La investigación de descubrimiento es esencial para avanzar en nuestra capacidad de comprender y mejorar la salud. Pero además de las ideas audaces e imaginativas de los investigadores, sabemos que también se necesitan nuevas herramientas, métodos y capacidades para desbloquear nuevas vías de investigación que puedan interrumpir y transformar el panorama de la investigación a nivel mundial”.

Los dos DRP de Cambridge, que recibirán 9 millones de libras esterlinas cada uno durante siete años, son:

La plataforma de investigación Discovery para biología a escala de tejidos – que busca trasladar la biología de células madre a la escala de investigación de tejidos y órganos, creando una nueva red de investigadores locales e internacionales para habilitar estrategias que capitalicen nuevos in vitro modelos para desarrollar mejores tratamientos para pacientes humanos.

El profesor Bertie Gottgens, director del Wellcome-MRC Cambridge Stem Cell Institute, dijo: «Estoy encantado de que Wellcome respalde nuestra ambición de construir una nueva Discovery Research Platform para proporcionar liderazgo internacional para la biología a escala de tejidos.

“Nuestra visión para esta plataforma fue el resultado de extensos debates en la comunidad más amplia de Cambridge Stem Cell y la formación de un equipo altamente interdisciplinario que conecta el Cambridge Stem Cell Institute con la comunidad de Ingeniería/Tecnología de West Cambridge. También incorpora nuevas y emocionantes asociaciones de capacitación con la Universidad Anglia Ruskin y la Academia de Ciencias y Tecnología de Cambridge, para ayudarnos a cubrir la escasez crítica de habilidades y ampliar la participación en Cambridge».

La plataforma de investigación Discovery para integrar la ciencia metabólica y endocrina – que tiene como objetivo abordar las barreras prácticas que impiden la integración de datos en la ciencia metabólica y endocrina, investigar cómo las hormonas controlan los procesos metabólicos y cómo estos pueden fallar en trastornos como la obesidad, la diabetes y la caquexia, y crear herramientas para facilitar el acceso global a estos datos. La Plataforma abarcará la investigación sobre moléculas, células y organismos modelo, pero tendrá un enfoque principal en la ciencia del descubrimiento en participantes humanos, pacientes y poblaciones.

La financiación sostendrá plataformas tecnológicas clave y el personal altamente capacitado necesario para respaldarlas. También respaldará las asociaciones con centros de investigación en todo el Reino Unido, así como en Alemania y Dinamarca, todo lo cual brindará nuevas oportunidades de capacitación.

La Plataforma tendrá un enfoque principal en la amplia difusión de datos integrados y la creación de herramientas para facilitar el acceso de la comunidad global. El premio también acelerará el impulso del equipo para realizar cambios transformadores en la cultura de la investigación con nuevas iniciativas para ampliar el acceso y la ciencia abierta reforzadas por un nuevo programa de investigación sobre la cultura de la ciencia biomédica, en colaboración con el Dr. Yeun Joon Kim, profesor asociado de la Escuela de Negocios Judge de Cambridge.

El profesor Sir Stephen O’Rahilly, codirector del Instituto de Ciencias Metabólicas Wellcome-MRC y director de la Unidad de Enfermedades Metabólicas del MRC, dijo: «El apoyo de Wellcome a la investigación de nuestros científicos en metabolismo y endocrinología, y a las plataformas tecnológicas que sustentan ha sido de vital importancia para los descubrimientos que hemos hecho y la traducción de esa investigación en mejoras en la salud. Este nuevo premio nos permitirá aprovechar esos logros y ofrecer más ciencia innovadora de una manera que enfatice la apertura, la diversidad y el espíritu de colaboración”.
Se ha iniciado la búsqueda de ‘súper memorizadores’ para ayudar a los científicos a descubrir los secretos de la memoria

Cualquier persona que crea que tiene una memoria excepcional está invitada a realizar una encuesta en línea y una prueba de memoria. En función de su desempeño, se invitará a algunas personas a Cambridge para someterse a un escáner cerebral para poder explorar en detalle los orígenes de la memoria excepcional.

El equipo también explorará si las personas autistas o neurodiversas tienen más probabilidades de tener una memoria excepcional.

Hace tiempo que se sabe que las personas difieren en su capacidad de memoria, y algunas tienen una memoria aparentemente infinita. Por ejemplo, el ensayista y escritor Daniel Tammet, con quien el equipo de Cambridge había trabajado anteriormente, estableció el récord europeo en 2004 por recitar el número pi de memoria después de recordarlo con 22.514 dígitos. Es autista y tiene sinestesia, donde los sentidos están interconectados, lo que puede explicar de alguna manera sus talentos.

El profesor Jon Simons del Departamento de Psicología de la Universidad de Cambridge dijo: “La memoria es uno de los procesos psicológicos mejor entendidos en términos de redes cerebrales y, sin embargo, todavía no sabemos por qué algunas personas tienen una memoria excepcional. Es por eso que estamos invitando a la gente a participar en nuestro estudio”.

El profesor Sir Simon Baron-Cohen, director del Centro de Investigación del Autismo de la Universidad de Cambridge e investigador principal del estudio, dijo: «No es necesario haber ganado ninguna competencia para participar o considerarse neurodiverso, y ciertamente no ¡No necesitas poder recitar pi hasta 22,000 dígitos! Estamos buscando a cualquiera que piense que podría ser un ‘súper memorizador’ para probar nuestras pruebas de memoria».

Cualquiera que quiera participar deberá realizar tres breves pruebas de memoria en línea, como memorizar un número de teléfono o patrones en un tablero de ajedrez. Cualquier persona que obtenga una puntuación alta en una o más de estas pruebas podría ser invitada a venir a Cambridge para hacerse un escáner cerebral con un escáner de resonancia magnética. Todos los gastos serán pagados.

Los científicos de Cambridge quieren saber si los cerebros de las personas que tienen una memoria excepcional muestran diferencias en cómo están estructurados o funcionan en comparación con aquellos que no la tienen: en resumen, ¿cómo logran sus notables proezas de memoria? El equipo también quiere investigar si el autismo da lugar a una mayor probabilidad de memoria excepcional.

La Dra. Carrie Allison, también del Centro de Investigación del Autismo, agregó: “Esperamos que las personas disfruten participando en este estudio y, en el proceso, contribuyan a ayudarnos a comprender más sobre la memoria y si la memoria excepcional está relacionada con el autismo. Durante décadas, la investigación del autismo se ha centrado en la discapacidad, pero este estudio es una oportunidad maravillosa para centrarse en las fortalezas”.

Para participar debes tener entre 16 y 60 años.

Primeros pasos con R Markdown

Independientemente del trabajo que realice, es importante poder crear documentos que le ayuden a comunicar su trabajo y sus resultados. Si usa R, puede intentar crear documentos comunicativos copiando y pegando su código y análisis en otras herramientas como Microsoft Word. Pero el proceso de copiar y pegar puede llevar mucho tiempo y puede ser muy difícil conservar el formato que desea. Es por eso que existe un paquete R llamado R Markdown. Con R Markdown, puede escribir código que no solo realiza los cálculos que forman parte de su flujo de trabajo de R, sino que también crea directamente documentos hermosos que pueden facilitar la comunicación.

Para comenzar con el paquete R Markdown, puede ejecutar el siguiente código para instalarlo y cargarlo en su sesión R:

install.packages("rmarkdown")
library(rmarkdown)

A continuación, debe crear un archivo donde escribirá todo su código R Markdown. Este archivo debe tener una extensión de archivo «.Rmd». Por ejemplo, puede llamar a su nuevo archivo rmdexample.Rmd. Este archivo contendrá el código R y el código de descuento y le facilitará la creación de un informe.

La primera parte de cada archivo R Markdown se denomina encabezado y contiene información importante sobre el título, el autor y el formato de su informe. El encabezado comienza y termina con tres guiones juntos (“—”). Aquí hay un encabezado de ejemplo:

---
title: "TPS Report"
author: Lawrence
date: April 7, 2023
output: html_document
---

Ahora que tiene un encabezado, ya está listo para crear o «renderizar» su informe. Puedes renderizarlo con el siguiente comando:

rmarkdown::render("rmdexample.Rmd")

Después de ejecutar este comando, verá (en cualquier directorio que esté usando para ejecutar R) que hay un nuevo archivo llamado «rmdexample.html». Este es el informe que ha creado con su código R Markdown, y verá que se ve así:

TPS Report
Lawrence
April 7, 2023

No es más que un título, autor y fecha, porque ese es el único contenido en su archivo Rmd (recuerde, lo único en su archivo es el encabezado). Se ha generado como un archivo HTML porque ese es el tipo de salida que especificó en su encabezado.

Ahora que puede crear un encabezado para su informe, querrá agregar contenido. Intente agregar el siguiente texto debajo del encabezado en su archivo Rmd:

# Useful R Markdown Information

Estos son algunos personajes que debes conocer:

  • Puede usar el carácter «#» para crear un título de sección.
  • Puede usar el carácter «*» para crear una viñeta.

Veamos cómo aparece el informe si renderizamos el documento nuevamente ejecutando rmarkdown::render(“rmdexample.Rmd”):

Informe GST
lorenzo
7 de abril de 2023
Información útil de rebajas de R
Aquí hay algunos personajes que debes conocer:

  • Puede usar el carácter «#» para crear un título de sección.
  • Puede usar el carácter «*» para crear una viñeta.

Puede ver que el carácter «#», cuando se usa al principio de una línea, crea un texto más grande que se puede usar para el título de una sección. Además, el carácter «*», cuando se usa al principio de una línea, crea una viñeta.

Lo mejor de R Markdown es que podemos agregar código R a los informes además de texto simple. Por ejemplo, si queremos crear y describir un marco de datos en el informe, podemos agregarle un código R visualizable agregando lo siguiente al final del archivo Rmd:

```{r}
names <- c("peter", "milton", "michael", "samir")
red_staplers <- c(0, 1, 0, 0)
dataframe <- data.frame(names, red_staplers)
print(dataframe)
```

Aquí, el texto «`{r}» indica que está comenzando una sección de código R puro, y los caracteres «` indican que la sección R pura está terminando. En el medio, hemos definido e impreso un marco de datos simple. Si renderiza el informe ahora, verá que se ve así:

Informe GST
lorenzo
7 de abril de 2023
Información útil de rebajas de R
Aquí hay algunos personajes que debes conocer:

  • Puede usar el carácter «#» para crear un título de sección.
  • Puede usar el carácter «*» para crear una viñeta.
names <- c("peter", "milton", "michael", "samir")
red_staplers <- c(0, 1, 0, 0)
dataframe <- data.frame(names, red_staplers)
print(dataframe)
##      names red_staplers
## 1    peter            0
## 2   milton            1
## 3  michael            0
## 4    samir            0

Puede ver que con R Markdown, podemos combinar texto descriptivo y código, en un estilo legible, en formatos de archivo comunes como HTML.

A medida que aprenda más sobre R Markdown, aprenderá a agregar otro texto y código atractivos a sus informes. Por ejemplo, puede agregar matemáticas, como el siguiente texto, a su informe:

# Math Section

$E = m cdot c^{2}$

Aquí, el carácter «$» indica el comienzo del texto que debe formatearse como una expresión matemática. El “cdot” es un atajo que se refiere a un punto que indica multiplicación. Si presenta esto en su informe, verá que se ve así:

Sección de Matemáticas
mi = m*c2

Felicitaciones, puede crear informes hermosos, legibles y basados ​​en código usando R Markdown. Si desea obtener más información sobre R Markdown u otros temas relacionados con el uso de R para la ciencia de datos, debe explorar la programación de Udacity para la ciencia de datos con R Nanodegree.

La vacuna contra el coronavirus sin aguja de la Universidad de Cambridge comienza los ensayos clínicos en la ciudad de origen

La vacuna, conocida como DIOS-CoVax, ha sido desarrollada por el profesor Jonathan Heeney de la Universidad de Cambridge y la empresa derivada DIOSynVax. Se concibe como un refuerzo dirigido al SARS-CoV-2 y parientes que amenazan futuras pandemias de coronavirus.

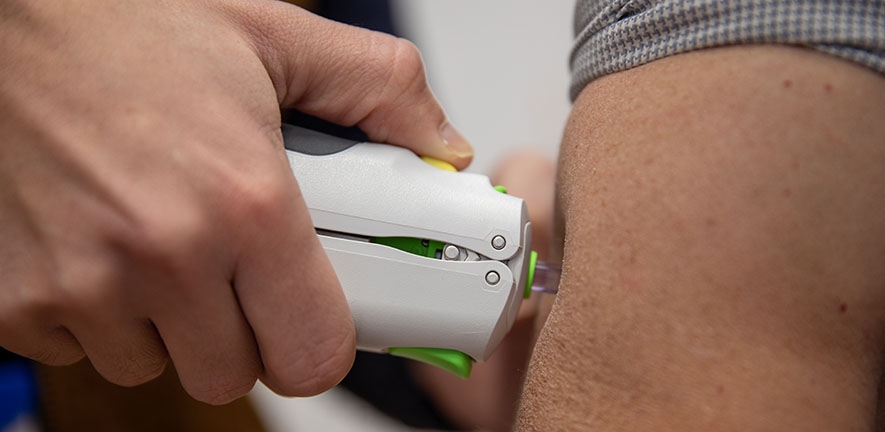
Esta vacuna de próxima generación se administra a través de una «inyección» sin aguja: una ráfaga de aire que la administra en la piel. Ya ha sido parte de los ensayos de seguridad realizados en el Centro de Investigación Clínica NIHR Southampton, pero ahora el reclutamiento se está expandiendo a Cambridge.

El profesor Heeney dijo: “Estamos entusiasmados de llevar nuestra vacuna a casa y buscamos reclutar voluntarios sanos para ayudar en esta etapa crucial de desarrollo hacia lo que esperamos que eventualmente se convierta en una vacuna universal contra el coronavirus.

“Nuestra vacuna es innovadora, tanto en términos de cómo pretende proteger contra el virus responsable de nuestra pandemia actual y futuros coronavirus, como en la forma en que se administra. Si eres alguien que odia las agujas, nuestra vacuna podría ser la respuesta, ya que se administra mediante un chorro de aire, no con una aguja”.

Si los ensayos clínicos tienen éxito, la vacuna podría ampliarse y fabricarse en forma de polvo para impulsar los esfuerzos mundiales de vacunación, en particular en los países de ingresos bajos y medianos.

El equipo de ensayos clínicos de Cambridge University Hospitals NHS Foundation Trust está buscando voluntarios sanos de entre 18 y 50 años para participar en el estudio. Los voluntarios recibirán un pago por su tiempo, y la participación en la prueba durará alrededor de 12 meses y los voluntarios asistirán a 11 visitas. Para obtener más información, comuníquese con el equipo de gestión del proyecto en [email protected].

La financiación para el desarrollo de la vacuna provino de Innovate UK, parte de UK Research and Innovation.

DIOSynVax es una empresa derivada de la Universidad de Cambridge, establecida en 2017 con el apoyo de Cambridge Enterprise, el brazo de comercialización de la Universidad. El profesor Heeney es miembro del Darwin College, Cambridge.

Investigación de Coursera en el informe WEF Future of Jobs 2023: los estudiantes sin títulos pueden aprender habilidades críticas tan rápido como los titulares de títulos

Por Jeff Maggioncalda, CEO de Coursera

Hoy, el Foro Económico Mundial (WEF, por sus siglas en inglés) lanzó su Informe sobre el Futuro de los Empleos 2023 que analiza el impacto de las disrupciones actuales del mercado laboral y revela las perspectivas de adopción de tecnología, empleos y habilidades en los próximos cinco años. Coursera tiene el honor de asociarse con el WEF para realizar investigaciones para el informe y demostrar cómo los enfoques basados ​​en habilidades para el desarrollo de la fuerza laboral pueden ayudar a los trabajadores desplazados a hacer la transición a los trabajos del futuro.

La transformación digital, la automatización y la globalización están creando una escasez de trabajadores calificados y una necesidad sin precedentes de volver a capacitarse y mejorar a nivel mundial. El impresionante aumento de la IA generativa agrava aún más la urgencia, ya que una nueva clase de trabajadores del conocimiento ahora corre el riesgo de ser desplazada. El informe Future of Jobs pronostica que más del 60% de los trabajadores requerirán una nueva capacitación entre ahora y 2027, pero se considera que solo la mitad de los trabajadores tienen acceso a oportunidades de capacitación adecuadas en la actualidad.

Los datos de Coursera en el informe Future of Jobs brindan información valiosa que puede guiar el desarrollo de estrategias de capacitación para trabajadores desplazados. Entre los hallazgos clave de nuestra investigación:

Los estudiantes sin títulos tardaron aproximadamente la misma cantidad de tiempo en adquirir habilidades clave que aquellos con títulos

La cantidad promedio de horas de aprendizaje que toman los estudiantes para completar con éxito las credenciales en Coursera no muestra evidencia de que los estudiantes sin un título tarden más en lograr una competencia de nivel principiante, intermedio o avanzado en cualquier habilidad. Este hallazgo destaca el potencial significativo de los enfoques basados ​​en habilidades, como las microcredenciales de la industria y la contratación basada en habilidades para abordar las brechas de habilidades y la escasez de talento.

Se necesita una acción colectiva de los sectores público y privado para proporcionar vías de actualización asequibles y flexibles para los trabajadores afectados. Los gobiernos y las instituciones de educación superior deben ofrecer programas académicos y de desarrollo de la fuerza laboral relevantes y escalables para abordar los desafíos de la dislocación laboral y el desempleo. Para los empleadores, un enfoque de talento basado en habilidades puede ayudar a expandir sus canales de contratación y crear vías de actualización para que los empleados se adapten a los requisitos de la fuerza laboral que cambian rápidamente.

Las personas han estado priorizando las habilidades técnicas, pero los empleadores están poniendo un nuevo énfasis en las habilidades humanas en medio de las necesidades laborales que cambian rápidamente.

Los estudiantes individuales de Coursera se han centrado principalmente en desarrollar habilidades técnicas que se asocian más comúnmente con carreras demandadas y bien remuneradas, como programación, redes, ciberseguridad, operaciones y administración de recursos. Si bien estas no son las principales habilidades que buscan los empleadores, según la Encuesta Future of Jobs, muchas son fundamentales para lograr una competencia avanzada en habilidades de alta prioridad como IA, big data, liderazgo e influencia social. Aunque los empleadores no enumeran explícitamente la lectura, la escritura y las matemáticas como habilidades de alta prioridad, estas habilidades siguen siendo una base importante para que cualquier persona que busca trabajo prospere en el lugar de trabajo.

En medio de este período de rápidos cambios y disrupciones, las empresas están poniendo mayor énfasis en las habilidades «socioemocionales» que permiten a su fuerza laboral responder de manera más efectiva al cambio, como la resiliencia, la agilidad, el liderazgo y el pensamiento analítico. Estas habilidades «humanas» son menos susceptibles a la automatización y son cada vez más importantes a medida que la tecnología acelera la tasa de cambio. Si bien las habilidades técnicas aún representan la mayoría de las horas de aprendizaje de las personas en Coursera, la evidencia sugiere que se está igualando, ya que las habilidades socioemocionales han aumentado constantemente su participación en las horas de aprendizaje de 2017 a 2023.

Si bien nuestra investigación indica que las instituciones y las personas deben invertir tanto en habilidades digitales como humanas, todavía hay brechas en las habilidades que buscan las personas y las habilidades que las empresas priorizan, y las instituciones tienen un papel importante que desempeñar para apoyar y empoderar a los trabajadores desplazados con las habilidades adecuadas. y credenciales para tener éxito en el nuevo mercado laboral.

Se lanza competencia de ficción flash para mujeres jóvenes en todo el país

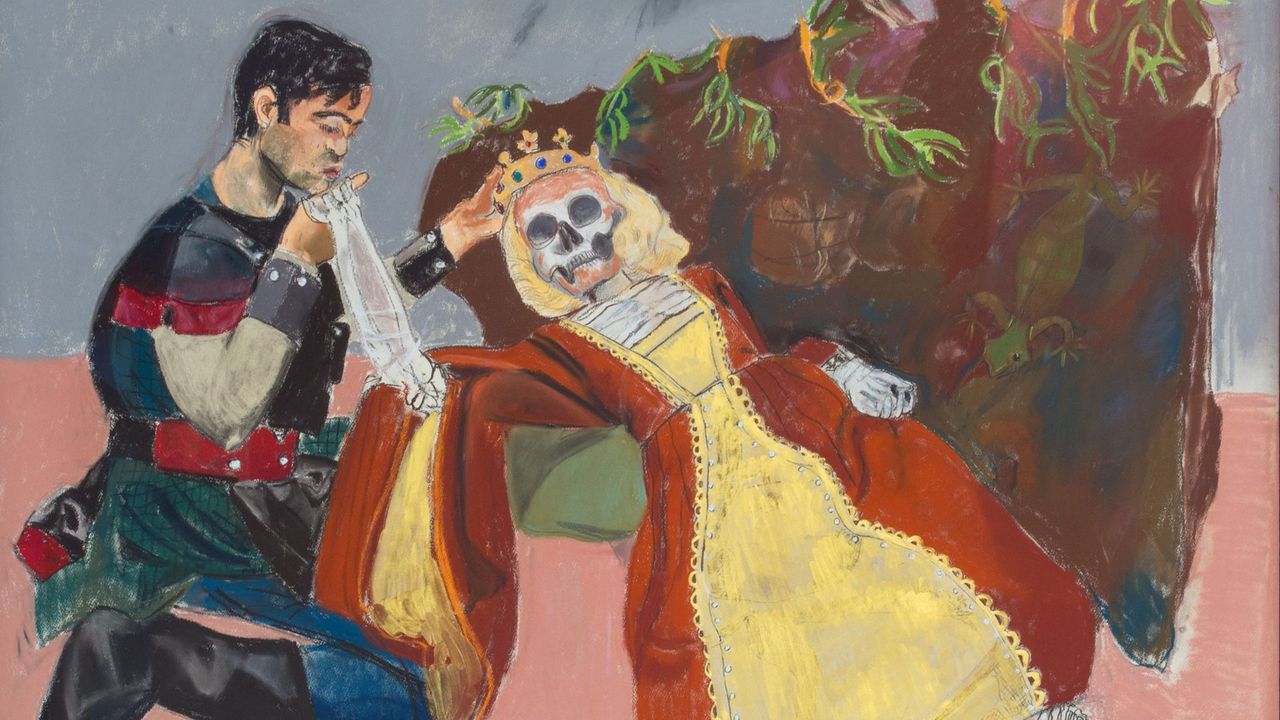
El concurso invita a los estudiantes a escribir hasta 250 palabras sobre la famosa pintura de Dame Paula Rego, Inés de Castro, que se creó en 2013 para marcar la admisión de Rego como miembro honorario del Colegio. La pintura es parte de The Women’s Art Collection en Murray Edwards, la mayor colección de arte de mujeres en Europa.

Las entradas ficticias pueden basarse en los hechos históricos de la pintura, el mito, o los escritores pueden dejar volar su imaginación e inspirarse en la obra de arte. Los jueces buscan premiar una prosa intensa, emocionante y original, inspirada en las artes visuales.

Las presentaciones serán evaluadas por la guionista y novelista Daisy Goodwin, la editora de cultura de la BBC Katie Razzall y el Dr. Leo Mellor, English Fellow en Murray Edwards College.

Daisy Goodwin dijo: “Murray Edwards tiene la colección de arte de mujeres más grande y emocionante de Europa. Es un gran lugar para estudiar y espero que este premio inspire a las mujeres jóvenes a venir y mirar el arte y la universidad».

Katie Razzell dijo: «De niña, a Paula Rego le encantaba que le contaran historias. Como artista, cada una de sus obras cuenta una historia, quizás ninguna más que su inquietante y macabro retrato de Inés de Castro. El arte de Rego refleja la condición humana en toda su ternura y belleza, crueldad y sufrimiento. Tengo muchas ganas de leer las historias de la competencia inspiradas en esta maravillosa pintura».

Hay tres categorías en las que pueden participar las mujeres jóvenes:

  • Mujeres jóvenes que actualmente están estudiando (ya sea como licenciatura o posgrado) en la Universidad de Cambridge. El ganador de esta categoría ganará £ 500.
  • Mujeres jóvenes en los años 12 y 13 que actualmente estudian A Levels o cualquier otra calificación académica en una escuela o universidad estatal en el Reino Unido. En esta categoría los premios serán en vales de libros; el ganador recibirá £100 y los tres finalistas recibirán £50 cada uno.
  • Estudiantes jóvenes de 7 a 11 años que actualmente estudian en una escuela o universidad estatal en el Reino Unido. En esta categoría los premios serán en vales de libros; el ganador recibirá £100 y los tres finalistas recibirán £50 cada uno.

La presidenta de Murray Edwards College, Dorothy Byrne, dijo: «La Colección de Arte de Mujeres inspira a nuestros estudiantes todos los días. Es fantástico vivir junto a una colección de arte con cientos de fotografías a nuestro alrededor. Esta fotografía es una de las más populares, hermosa y extraña».

Los detalles completos sobre cómo ingresar, así como los Términos y condiciones, se pueden encontrar en el sitio web de Murray Edwards College.

—

La Colección de Arte de Mujeres en Murray Edwards College es la colección de arte de mujeres más grande de Europa. Incluye 600 obras de artistas destacados como Barbara Hepworth, Paula Rego, Lubaina Himid, Faith Ringgold, Tracey Emin y Cindy Sherman.

Fundada a principios de la década de 1990, la Colección desafía la representación insuficiente de mujeres artistas en museos y galerías. Se exhibe en todo el Murray Edwards College, un icónico edificio brutalista diseñado por Chamberlin, Powell y Bon como un manifiesto para la educación de las mujeres. Las obras de arte se cuelgan en las salas públicas y los pasillos de los estudiantes y las esculturas forman parte de los jardines naturales del Colegio. En 2018, la Colección recibió la Acreditación de Museo del Consejo de las Artes de Inglaterra.

Hoy, el Colegio continúa celebrando y apoyando a las mujeres artistas, organizando dos exhibiciones al año, junto con un programa de eventos que incluye charlas, recorridos, talleres, proyecciones y actuaciones.

La Colección está abierta al público todos los días de 10 a. m. a 6 p. m. y la visita es gratuita.

Casi la mitad de las personas con conmoción cerebral todavía muestran síntomas de lesión cerebral seis meses después

Lesión cerebral traumática leve (conmoción cerebral) como resultado de un golpe o sacudida en la cabeza. Puede ocurrir como resultado de una caída, una lesión deportiva o por un accidente de bicicleta o automóvil, por ejemplo. Pero a pesar de estar etiquetado como ‘leve’, comúnmente se relaciona con síntomas persistentes y una recuperación incompleta. Dichos síntomas incluyen depresión, deterioro cognitivo, dolores de cabeza y fatiga.

Si bien algunos médicos en estudios recientes predicen que nueve de cada 10 personas que experimentan una conmoción cerebral se recuperarán por completo después de seis meses, está surgiendo evidencia de que solo la mitad logra una recuperación completa. Esto significa que una proporción significativa de pacientes puede no recibir la atención adecuada después de la lesión.

Sin embargo, predecir qué pacientes tendrán una recuperación rápida y quién tardará más en recuperarse es un desafío. En la actualidad, a los pacientes con sospecha de conmoción cerebral generalmente se les realiza una exploración cerebral, ya sea una tomografía computarizada o una resonancia magnética, las cuales buscan problemas estructurales, como inflamación o hematomas, pero incluso si estas exploraciones no muestran daño estructural evidente, el paciente los síntomas aún pueden persistir.

El Dr. Emmanuel Stamatakis, del Departamento de Neurociencias Clínicas y la División de Anestesia de la Universidad de Cambridge, dijo: «En todo el mundo, estamos viendo un aumento en la cantidad de casos de lesiones cerebrales traumáticas leves, particularmente por caídas en nuestra población que envejece y números crecientes de colisiones de tránsito en países de bajos y medianos ingresos.

“Actualmente, no tenemos una forma clara de determinar cuál de estos pacientes tendrá una recuperación rápida y cuál llevará más tiempo, y la combinación de pronósticos demasiado optimistas e imprecisos significa que algunos pacientes corren el riesgo de no recibir la atención adecuada para sus síntomas. ”

El Dr. Stamatakis y sus colegas estudiaron escáneres cerebrales fMRI, es decir, escáneres de resonancia magnética funcional, que analizan cómo las diferentes áreas del cerebro se coordinan entre sí, tomados de 108 pacientes con lesión cerebral traumática leve y los compararon con escáneres de 76 voluntarios sanos. Los pacientes también fueron evaluados por síntomas continuos.

Los pacientes y voluntarios habían sido reclutados para CENTER-TBI, un gran proyecto de investigación europeo cuyo objetivo es mejorar la atención de los pacientes con lesión cerebral traumática, copresidido por el profesor David Menon (jefe de la división de Anestesia) y financiado por la European Unión.

En los resultados publicados hoy en Cerebroel equipo descubrió que poco menos de la mitad (45 %) seguía mostrando síntomas como resultado de su lesión cerebral, siendo los más comunes fatiga, falta de concentración y dolores de cabeza.

Los investigadores encontraron que estos pacientes tenían anomalías en una región del cerebro conocida como tálamo, que integra toda la información sensorial y transmite esta información alrededor del cerebro. En contra de la intuición, la conmoción cerebral se asoció con una mayor conectividad entre el tálamo y el resto del cerebro; en otras palabras, el tálamo estaba tratando de comunicarse más como resultado de la lesión, y cuanto mayor sea esta conectividad, peor será el pronóstico para el paciente.

Rebecca Woodrow, estudiante de doctorado en el Departamento de Neurociencia Clínica y Hughes Hall, Cambridge, dijo: «A pesar de que no hubo un daño estructural obvio en el cerebro en las exploraciones de rutina, vimos evidencia clara de que el tálamo, el sistema de retransmisión del cerebro, estaba hiperconectado. . Podríamos interpretar esto como que el tálamo intenta compensar en exceso cualquier daño anticipado, y esto parece ser la raíz de algunos de los síntomas duraderos que experimentan los pacientes”.

Al estudiar datos adicionales de tomografías por emisión de positrones (PET), que pueden medir la composición química regional de los tejidos corporales, los investigadores pudieron establecer asociaciones con neurotransmisores clave según los síntomas a largo plazo que mostrara un paciente. Por ejemplo, los pacientes que experimentaron problemas cognitivos, como dificultades de memoria, mostraron una mayor conectividad entre el tálamo y las áreas del cerebro ricas en el neurotransmisor noradrenalina; los pacientes que experimentaron síntomas emocionales, como depresión o irritabilidad, mostraron una mayor conectividad con áreas del cerebro ricas en serotonina.

El Dr. Stamatakis, que también es Stephen Erskine Fellow en Queens’ College, Cambridge, agregó: «Sabemos que ya existen medicamentos que se dirigen a estos químicos cerebrales, por lo que nuestros hallazgos ofrecen la esperanza de que en el futuro, no solo podamos predecir el pronóstico de un paciente , pero también podemos ofrecer un tratamiento dirigido a sus síntomas particulares”.

Referencia
Woodrow, RE et al. La conectividad talámica aguda precede a los síntomas posconmocionales crónicos en la lesión cerebral traumática leve. Cerebro; 26 de abril de 2023; DOI: 10.1093/cerebro/awad056

Gracias, siguiente (): familiarizarse con los iteradores de Python

Escribir código, como escribir poesía, literatura o publicaciones de blog, está lleno de opciones estilísticas. Si trabaja con un desarrollador el tiempo suficiente, conocerá estas opciones. El código, como la palabra escrita, requiere el uso de convenciones comunes para cumplir su propósito. En Python, una de las convenciones más importantes, y que a menudo es invisible para nosotros de la misma manera que el orden de las palabras es invisible para nosotros, es el uso de iteradores.

Iteradores que ya conocemos

Si alguna vez ha escrito un bucle for, ha utilizado un iterador, ¡lo sepa o no! Consultando la propuesta de mejora de Python (PEP) que propuso iteradores, PEP 234, un iterador en Python es cualquier objeto que implementa un método __iter__() y un método __next__(). Eso significa que las principales estructuras de datos integradas que usamos en Python: list, dict, set y tuple, son todos objetos iterables: objetos a los que podemos llamar iter() para generar un iterador. Esta es una distinción importante, ya que, por ejemplo, una lista no es en sí misma un iterador, sino que ES un objeto iterable.

>>> my_list = [1, 2, 3, 4]
>>> next(my_list)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'list' object is not an iterator

Sin embargo, si llamamos iter en nuestra lista:

>>> my_list = [1, 2, 3, 4]
>>> my_iterator = iter(my_list)
>>> next(my_iterator)
1
>>> next(my_iterator)
2

Continúe y ejecute el código anterior en su REPL de Python y vea qué sucede cuando llama a next() por quinta vez: ¡lo detiene!

Si bien es posible que no haya utilizado recientemente, o nunca, el método next() de un iterador, probablemente haya utilizado la sintaxis for… in… Cuando escribimos un bucle for, bajo el capó, el intérprete de Python está creando un objeto iterador y llamando al método next() por nosotros.

my_dict = {
"spam": 1,
"ham": 1,
"eggs": 2,
"cheese": 3 
}

for k, v in my_dict.items():
print(v, k)

Ejecutar este código nos da el siguiente resultado:

>python example.py
1 spam
1 ham
2 eggs
3 cheese

Ahora, si quisiéramos usar un iterador de nuestro diccionario, podríamos usar un ciclo while como este y obtener el mismo resultado:

my_dict = {
"spam": 1,
"ham": 1,
"eggs": 2,
"cheese": 3 
}

dict_iterator = iter(my_dict.items())
i = 0
while i < len(my_dict):
k, v = next(dict_iterator)
print(v, k)
i += 1

Creando nuestro propio iterador

Como sabemos, cualquier objeto con un método __iter__() y un método __next__() es un iterador. También sabemos que llamar a iter() en nuestros objetos iterables nos proporciona un iterador. Pero, ¿y si queremos construir un iterador personalizado? Consideremos el siguiente código.

class Fibonacci():
    def __init__(self):
       self.value = 1
       self.previous = 0

    def __iter__(self): 
        return self

    def __next__(self):
        current = self.value
        previous = self.previous
        self.value = current + previous
        self.previous = current
        return current

¡Este iterador comenzará con 1, y cada llamada a next() devolverá el elemento next() de la secuencia de Fibonacci! (Dejaremos a un lado los argumentos sobre la secuencia que comienza en 0 y reconoceremos que si solo cambiamos el retorno actual para regresar al anterior, obtenemos la secuencia indexada en 0)

Entonces, ¿cómo funciona eso?

iterator = Fibonacci()
print(next(iterator))

Dado el objeto de Fibonacci, el código anterior generará la secuencia: 1, 1, 2, 3, 5, 8. Esto se debe a que estamos llamando a next() en nuestro iterador manualmente. ¿Qué sucede si ejecutamos el siguiente código?

iterator = Fibonacci()
for element in iterator:
    print(element)

En este caso, dado que no hay límites, el código se ejecutará para siempre (¡o al menos hasta que interrumpa el proceso!). A diferencia del objeto my_iterator de nuestro primer ejemplo que llama a iter() en un objeto de lista, no hay un elemento final de este iterador, por lo que nunca generará una excepción StopIteration. Si queremos hacer esto, simplemente podemos modificar nuestro objeto para que deje de iterar cuando alcance un valor mayor que algún límite superior arbitrario.

class Fibonacci():
    def __init__(self, max_val):
       self.value = 1
       self.previous = 0
       self.max_val = max_val

    def __iter__(self): 
        return self

    def __next__(self):
        if self.value > self.max_val:
            raise StopIteration
        current = self.value
        previous = self.previous
        self.value = current + previous
        self.previous = current
        return current

iterator = Fibonacci(20)
for element in iterator:
    print(element)

Ejecutar este código generará: 1, 1, 2, 3, 5, 8, 13 ya que el siguiente valor más grande de la secuencia es 21, que es mayor que nuestro valor máximo especificado de 20.

Conclusión

Los iteradores son una parte increíblemente importante del código de Python. Aunque los iteradores reales a menudo se abstraen de nosotros y, en su lugar, recorremos los objetos iterables, hay momentos en los que querremos o necesitaremos implementar nuestros propios objetos iterables. Es importante para nosotros saber cómo construir nuestros métodos __iter__() y __next__(). Para las aplicaciones de ciencia de datos y aprendizaje automático en grandes conjuntos de datos, se usa con frecuencia un tipo especial de iterador conocido como generador. Si eso te emociona, entonces lo siguiente () que debes hacer es consultar el programa Programación para la ciencia de datos con Python Nanodegree.

Fotografía de la llegada del ex Príncipe de Gales a Cambridge en 1967, publicada por primera vez

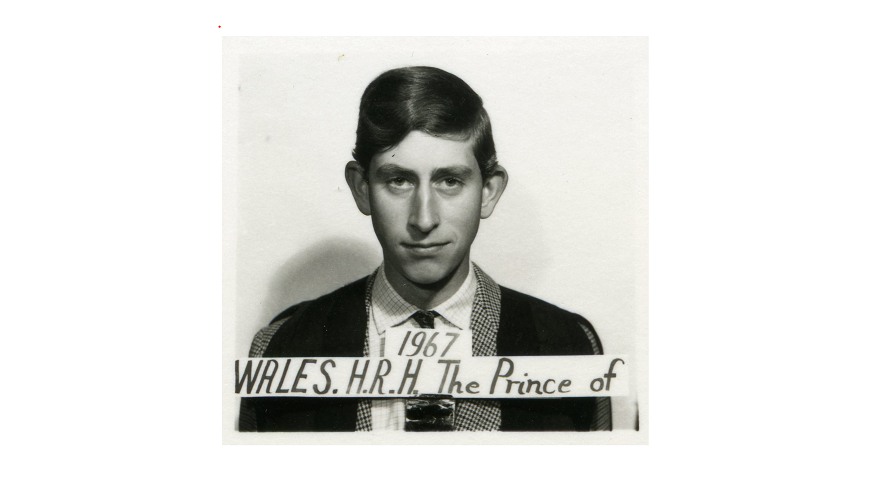
El Príncipe de Gales, de 18 años, posó para su fotografía en la Biblioteca Wren en octubre de 1967, continuando el rito de iniciación que marca el inicio de los estudios universitarios en Trinity y Cambridge: matriculación y admisión.

La fotografía, en el archivo de Trinity desde que fue tomada hace 56 años, se publica por primera vez antes de la Coronación de Su Majestad el Rey Carlos III, como parte de las celebraciones del Colegio.

Como Príncipe de Gales, Charles estudió Arqueología y Antropología en su primer año y luego Historia durante dos años. Se graduó en 1970.

En Cambridge, los estudiantes se matriculan cuando aceptan observar los Estatutos y Ordenanzas de la Universidad. Luego son admitidos en la universidad de su elección, una de las 29 universidades de Cambridge que aceptan estudiantes universitarios.

En el día del Príncipe de Gales, la admisión a Trinity involucraba tres elementos: ser fotografiado individualmente para el registro, completar el Libro de Admisiones y entregar una toga para la fotografía de Matriculación (de Freshers, la nueva cohorte de estudiantes).

Trinity Fellow, el profesor Adrian Poole, contemporáneo del ex Príncipe de Gales, recuerda la experiencia de la ‘foto policial’ de matriculación.

«Para prácticamente todos nosotros, era nuestra primera vez en la Biblioteca Wren. Estábamos sobrecogidos y un poco intimidados. ¿Estábamos en el lugar correcto? Tantos libros. Bustos de Cicerón y Marco Aurelio. Una estatua de Byron. Un Príncipe más o menos apenas parecía fuera de lugar».

Dos de las tradiciones anteriores de Admisión a la Universidad permanecen hoy. Los Freshers deben ingresar sus datos en el Libro de Admisiones; unirse a la fotografía del grupo de año es opcional.

Los Evangelios de Agustín de Cambridge aparecerán en Coronation

Los evangelios de Agustín

Los Evangelios se llevarán en la procesión inicial y luego formarán parte del servicio.

Su Majestad el Rey vio los Evangelios por primera vez en una visita como Príncipe de Gales a su casa en la Biblioteca Parker de la universidad en 2001. Inmediatamente reconoció su importancia como posiblemente el manuscrito medieval más preciado e importante de Inglaterra, y posteriormente solicitó que se llevaran a cabo. en su procesión de Coronación.

Para la historia completa ver aquí.

Los Evangelios del siglo VI de Agustín de Canterbury, que se encuentran en Corpus Christi College, Cambridge, aparecerán en la coronación del rey Carlos III.

Los evangelios de Agustín

Licencia Creative Commons.

El texto de este trabajo tiene una licencia internacional Creative Commons Attribution-NonCommercial-ShareAlike 4.0. Las imágenes, incluidos nuestros videos, tienen Copyright © de la Universidad de Cambridge y los otorgantes de licencias/colaboradores identificados. Reservados todos los derechos. Hacemos que nuestro contenido de imagen y video esté disponible de varias maneras, como aquí, en nuestro sitio web principal según sus Términos y condiciones, y en una variedad de canales, incluidas las redes sociales, que le permiten usar y compartir nuestro contenido según sus respectivos Términos.

Sí

Las sequías prolongadas probablemente significaron el fin de las megaciudades del Indo

El comienzo de este período árido, que comenzó hace unos 4.200 años y duró más de dos siglos, coincide con la reorganización de la civilización del Indo, que construyó metrópolis y abarcó los actuales Pakistán e India.

La investigación identificó tres sequías prolongadas, cada una con una duración de entre 25 y 90 años, durante este período árido. «Encontramos evidencia clara de que este intervalo no fue una crisis a corto plazo, sino una transformación progresiva de las condiciones ambientales en las que vivía la gente del Indo», dijo el coautor del estudio, el profesor Cameron Petrie, del Departamento de Arqueología de Cambridge.

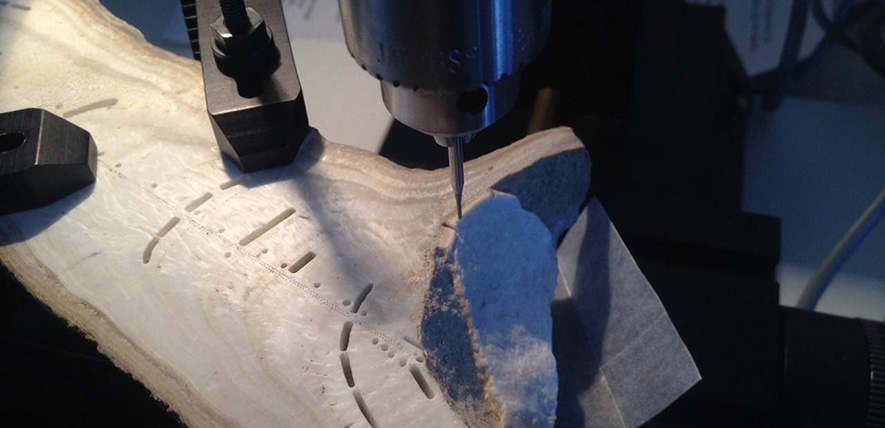
Los investigadores registraron las precipitaciones históricas al examinar las capas de crecimiento en una estalagmita recolectada en una cueva cerca de Pithoragarh, India. Al medir una variedad de indicadores ambientales, incluidos los isótopos de oxígeno, carbono y calcio, obtuvieron una reconstrucción que muestra la precipitación relativa con una resolución estacional. También utilizaron datación en serie de uranio de alta precisión para controlar la edad y la duración de las sequías.

«Múltiples líneas de evidencia nos permiten reconstruir la naturaleza de estas sequías desde diferentes ángulos, y confirmar que están de acuerdo», dijo la autora principal de la investigación, Alena Giesche, quien realizó la investigación como parte de su doctorado en el Departamento de la Tierra de Cambridge. Ciencia.

Giesche y el equipo identificaron distintos períodos de lluvia por debajo del promedio tanto en el verano como en el invierno. “La evidencia de sequía que afectó a ambas temporadas de cultivo es extremadamente importante para comprender el impacto de este período de cambio climático en las poblaciones humanas”, dijo Petrie. Agrega que las sequías durante este período aumentaron en duración, hasta el punto en que la tercera habría sido multigeneracional en duración.

Los hallazgos respaldan la evidencia existente de que el declive de las megaciudades del Indo estaba relacionado con el cambio climático. “Pero lo que ha sido un misterio hasta ahora es la información sobre la duración de la sequía y la temporada en la que ocurrieron”, dijo Giesche. “Ese detalle adicional es realmente importante cuando consideramos la memoria cultural y cómo las personas se adaptan cuando se enfrentan al cambio ambiental”.

Según Petrie: “La evidencia arqueológica indica que durante un período de 200 años, los antiguos habitantes tomaron varias medidas para adaptarse y mantenerse sostenibles frente a esta nueva normalidad”. Durante esta transformación, los sitios urbanos más grandes fueron despoblados en favor de asentamientos rurales más pequeños hacia la extensión oriental del área ocupada por las poblaciones del Indo. Al mismo tiempo, la agricultura cambió hacia la dependencia de los cultivos de verano, especialmente el mijo tolerante a la sequía, y la población hizo la transición a un estilo de vida que parece haber sido más autosuficiente.

Las megasequías se han convertido recientemente en una causa popular para explicar una serie de transformaciones culturales, incluido el valle del Indo, explica David Hodell, coautor del estudio del Departamento de Ciencias de la Tierra de Cambridge. “Pero los vínculos son generalmente confusos debido a las dificultades que implica comparar los registros climáticos y arqueológicos”. Esto ahora está cambiando porque “los registros paleoclimáticos son cada vez mejores para refinar los cambios en las precipitaciones estacionales y anuales, lo que afecta directamente la toma de decisiones de las personas”, dijo Hodell.

El equipo ahora busca expandir sus reconstrucciones climáticas a las partes occidentales de la región del río Indo, donde el sistema de lluvias invernales se vuelve más dominante que el monzón de verano indio. “Lo que realmente necesitamos son más registros como este, de un transecto orientado de oeste a este a través de la región donde interactúan los monzones de verano e invierno y, lo que es más importante, capturar el comienzo de este período árido”, dijo Giesche.

“Actualmente, tenemos un gran punto ciego en nuestros mapas que se extiende por Afganistán y Pakistán, donde interactúan el monzón de verano de la India y los vientos del oeste”, dijo el Prof. Sebastian Breitenbach, coautor y paleoclimatólogo de la Universidad de Northumbria. «Lamentablemente, es poco probable que la situación política permita este tipo de investigación en un futuro próximo».

“Hay más trabajo por hacer tanto por parte de los paleoclimatólogos como de los arqueólogos”, dijo Hodell. “Somos afortunados en Cambridge de tener los dos departamentos uno al lado del otro”.

Rastrear cómo las zonas de lluvia que interactúan influyeron en la civilización del Indo ha sido una de las preguntas en el centro del Proyecto TwoRains, una colaboración entre Cambridge y la Universidad Hindú de Banaras, que fue financiada por el Consejo Europeo de Investigación (ERC).

Giesche, A., Hodell, DA, Petrie, CA, Haug, GA, Adkins, JF, Plessen, B., Marwan, N., Bradbury, HJ, Hartland, A., French, AD Breitenbach, SFM 2023. Evidencia de espeleotema para sequías recurrentes de verano e invierno posteriores a 4,2 ka en la cuenca del río Indo, Nature Communications Earth & Environment (2023), https://doi.org/10.1038/s43247-023-00763-z.